Tag

Alles zu nkrunner auf einer Seite

Alle Inhalte mit dem Tag nkrunner am Stück auf einer Seite.

9. Mai 2026

Z-Fighting und Picking: Orthogonale Tiefensortierung durch ADTs

Eine Spatial UI, die im echten 3D-Raum gerendert wird, unterliegt den mathematischen Limitierungen der Grafik-Pipeline. Ein klassisches Problem bei der Konstruktion von verschachtelten 2D-Interfaces in einer 3D-Welt ist koplanare Geometrie: Ein Textfeld-Hintergrund, der darauf liegende Text und eine danebenliegende Scrollbar besitzen fast identische Z-Koordinaten im Weltraum.

Aufgrund der begrenzten Präzision des Tiefenpuffers kann die Grafikkarte nicht verlässlich entscheiden, welches Fragment vorne liegt. Das Resultat ist Z-Fighting (visuelles Flackern).

Exkurs: Warum der Tiefenpuffer ungenau wird
Der Z-Buffer (Tiefenpuffer) der Grafikkarte speichert die Entfernung jedes Pixels zur Kamera. Bei perspektivischen Projektionen verläuft diese Auflösung jedoch nicht linear. Nah an der Kamera ist die Präzision extrem hoch. Je weiter ein Objekt entfernt ist, desto weniger Bits stehen für die Tiefenunterscheidung zur Verfügung. Zwei Flächen mit winzigem Abstand (z. B. 0.001 Einheiten) werden in der Ferne für die GPU mathematisch auf denselben Wert gerundet – das Flackern beginnt.

Das eigentliche Problem: Falsche Picking-Ergebnisse

Das visuelle Flackern ist jedoch nur ein Symptom. Das gravierendere Problem betrifft die Interaktion.

Wie in einem früheren Beitrag beschrieben, nutzt die Engine einen separaten Offscreen-Pass für das "Picking". Wenn nun die Z-Sortierung instabil ist, passiert folgendes: Die unsichtbare, großflächige Hintergrund-Geometrie einer Textzeile verdeckt mathematisch den schmalen Anfasser der Scrollbar. Der Nutzer klickt optisch auf die Scrollbar, der Auslesevorgang aus dem Framebuffer liefert jedoch die ID des Textfeldes zurück. Das UI-Element wird unbedienbar.

Exkurs: Offscreen Picking
Um zu wissen, worauf der Nutzer klickt, verwendet die Engine kein mathematisches Raycasting (Schnittpunktberechnung von Linien mit 3D-Boxen). Stattdessen wird die Szene unsichtbar im Hintergrund ein zweites Mal gezeichnet. Jedes anklickbare Element (Button, Scrollbar, Textfeld) erhält dabei keine echte Textur, sondern eine einzigartige, flache Farbe (z. B. Rotwert 12, Grünwert 104). Klickt der Nutzer, liest die CPU die Farbe des Pixels unter dem Mauszeiger aus und rechnet diese Farbe wieder in die exakte ID des UI-Elements.

Warum überhaupt ein Tiefenpuffer? (Maleralgorithmus vs. Multithreading)
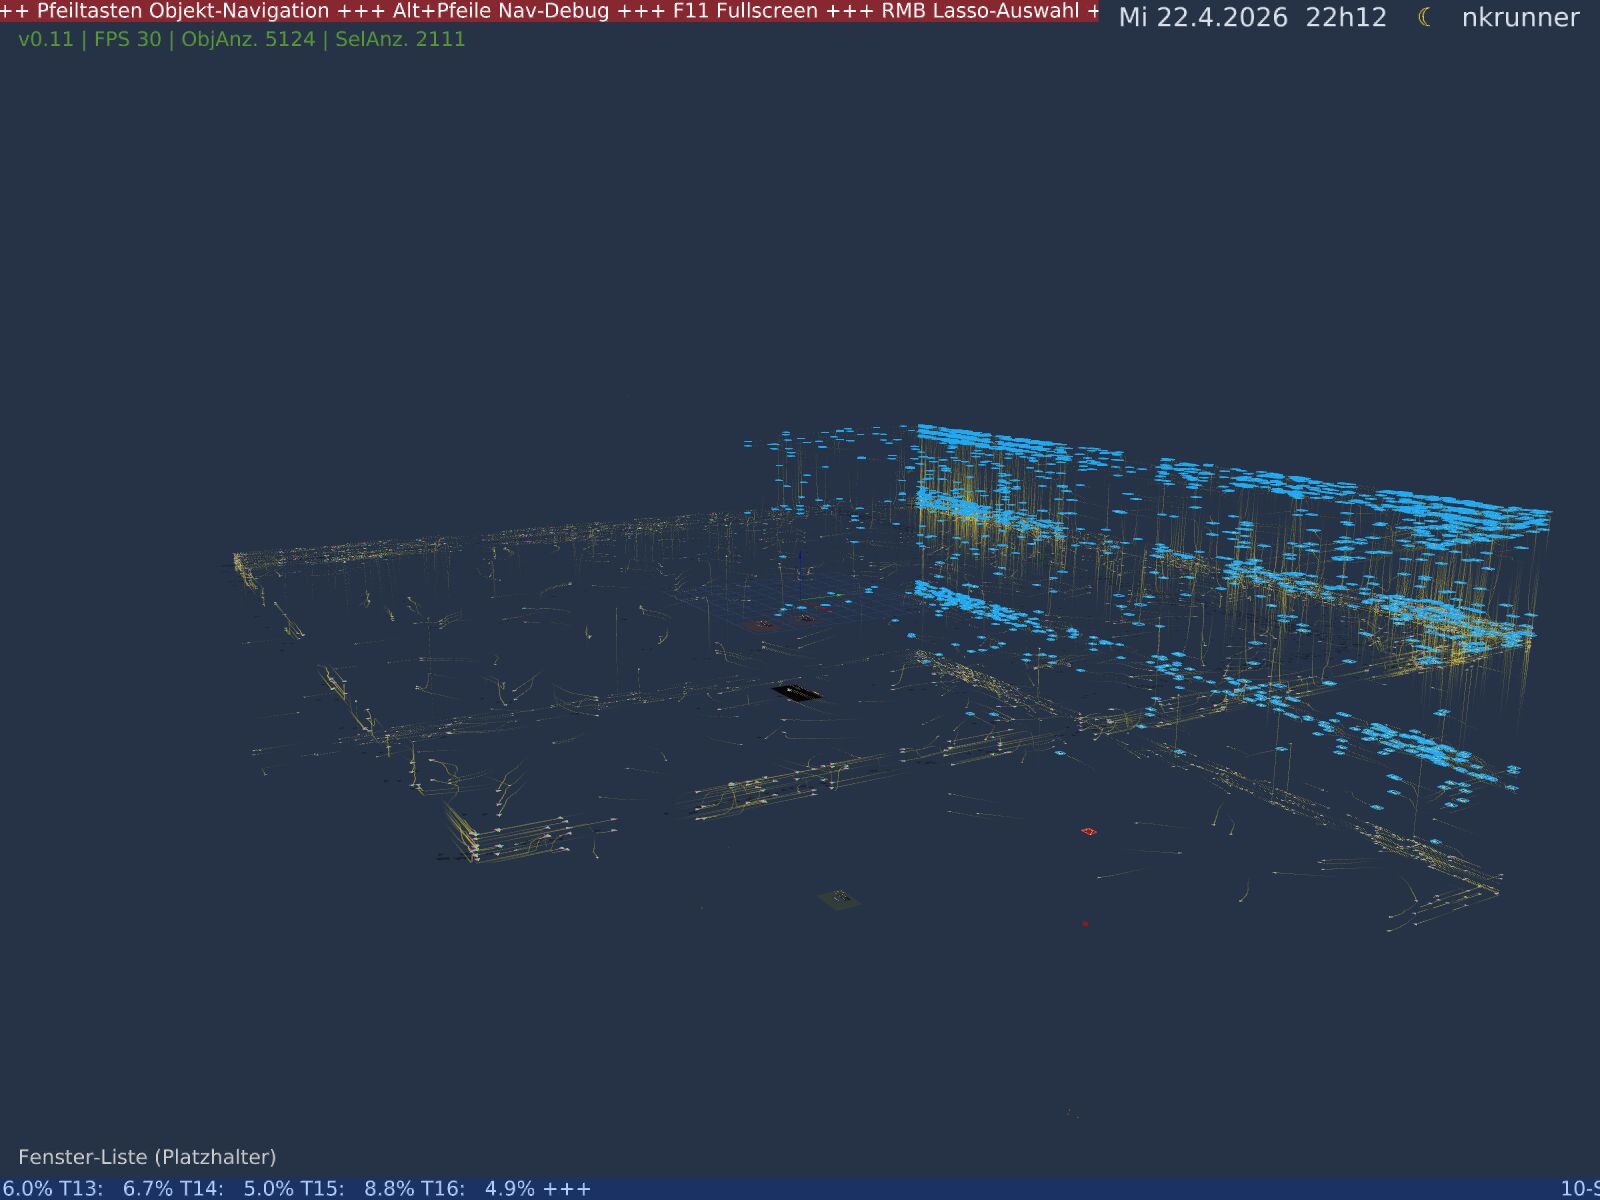
Die Spatial UI im Einsatz

An dieser Stelle drängt sich eine berechtigte Architektur-Frage auf: Klassische 2D-Benutzeroberflächen (wie der Browser oder Standard-Desktop-Apps) benötigen für ihre Fensterinhalte meist gar keinen Tiefenpuffer. Warum verzichten wir nicht einfach darauf und zeichnen die Elemente strikt sequenziell von hinten nach vorne?

Dieses Konzept nennt sich Maleralgorithmus (Painter's Algorithm): Zuerst wird der Hintergrund gezeichnet, dann das Formular, dann die Scrollbar, zuletzt der Text. Was später an die Grafikkarte geschickt wird, übermalt schlicht die vorherigen Pixel. Z-Fighting existiert hier nicht, da die Zeichenreihenfolge (Draw Order) die Sichtbarkeit diktiert.

Dass wir diesen Weg in der Engine verlassen müssen, hat zwei zwingende Gründe:

  1. Echtes 3D (Spatial UI): Da unsere Fenster frei im 3D-Raum schweben und die Kamera sich kippen lässt, können sich Fenster gegenseitig durchdringen. Die CPU müsste in jedem Frame alle tausenden UI-Dreiecke mathematisch nach ihrer Distanz zur Kamera sortieren. Das ist ein massiver CPU-Flaschenhals.
  2. Lock-free Multithreading: Dies ist der entscheidende Punkt. Wie in einem früheren Devlog beschrieben, generieren wir die Geometrie für hunderte Objekte echtzeitfähig durch asynchrone Worker-Threads. Alle Prozessorkerne schreiben ihre Daten gleichzeitig in einen großen, gemeinsamen Vertex-Puffer. Dadurch ist die finale Reihenfolge der Dreiecke im Speicher nicht deterministisch. Ein Thread ist vielleicht mit den Textbuchstaben schneller fertig als ein anderer Thread mit dem zugehörigen Hintergrund.

Wir können uns also schlicht nicht auf eine vorhersehbare Zeichenreihenfolge verlassen. Wir delegieren das Problem der Verdeckung komplett an die Hardware der Grafikkarte – den Z-Buffer. Dieser per-Pixel Tiefentest ermöglicht erst unsere massive Parallelisierung auf der CPU, erfordert als Vertragspreis dafür aber zwingend exakte, mathematisch eindeutige Z-Koordinaten für jedes einzelne UI-Fragment.

"Primitive Obsession" und Magic Numbers

Die pragmatische, aber architektonisch unsaubere Lösung, um diese eindeutigen Z-Koordinaten herzustellen, sind fest kodierte Offsets (Magic Numbers). Bei der Generierung der Render-Befehle werden manuelle Fließkommawerte addiert: z + 0.001 für den Hintergrund, z + 0.002 für die Scrollbar.

Das führt zu einem klassischen Architekturfehler: der Primitive Obsession.

Exkurs: Was ist Primitive Obsession?
Der Begriff stammt aus der Refactoring-Literatur. Er beschreibt den Code-Smell (Gestank), wenn komplexe Domänenkonzepte durch fundamentale Basis-Datentypen (Primitives wie int, float oder string) abgebildet werden. Aber warum "Obsession" (Besessenheit)? Weil Programmierer dazu neigen, aus reiner Bequemlichkeit geradezu zwanghaft an diesen eingebauten Standard-Typen festzuhalten. Es fühlt sich im ersten Moment nach unnötigem Overhead an, für eine simple Tiefenkoordinate extra einen neuen Datentyp zu deklarieren. Man denkt sich: "Ein float reicht doch völlig aus!" und nutzt ihn einfach überall. Man ist "besessen" davon, alles mit primitiven Basiswerkzeugen zu erschlagen, und weigert sich, der Domäne ein eigenes Vokabular zu geben. Das rächt sich, weil der Compiler dann nicht mehr bei Logikfehlern helfen kann: Ein Betrag von "50 Euro" ist fachlich kein float (50.0), sondern sollte ein Typ Money sein. Und die topologische Reihenfolge von UI-Elementen ist kein float, sondern ein Typ Layer.

Die Reihenfolge von UI-Elementen ist eine strukturelle Information, keine Fließkommazahl. Kapselt man dies in primitiven float-Werten, wird diese Regel über alle Abstraktionsschichten hinweg ungeschützt durchgereicht. Sobald neue GUI-Komponenten hinzukommen, kollidieren die Offsets unweigerlich. Eine nachträgliche Korrektur erfordert das Anpassen global verteilter Konstanten.

Die Lösung: Topologie in das Typsystem heben

Um das Problem strukturell zu lösen, wurde die Z-Tiefensortierung innerhalb von UI-Frames aus der Geometrie-Ebene entfernt und in das Typsystem der Engine verlagert.

Anstatt rohe Z-Offsets zu verwenden, ordnet das Layout-System Render-Befehle nun einem abstrakten Datentyp (ADT). Dieser definiert ein geschlossenes Vokabular der topologischen Schichten:

Exkurs: Algebraic Data Types (ADTs)
Ein ADT erlaubt es, eine exakt begrenzte, geschlossene Menge an gültigen Zuständen zu definieren. Im Gegensatz zu einem float, der unendlich viele (und oft ungültige) Werte annehmen kann, lässt ein Aufzählungstyp (Enum/Sum Type) nur die exakt definierten Ausprägungen zu. Der Compiler garantiert, dass keine anderen Werte in das System eingeschleust werden.

Das System kennt nun folgende strikte Hierarchie:

  1. Fenster-Hintergrund
  2. Formular-Hintergrund (z. B. Input-Boxen)
  3. Aktive Zustände (z. B. aktivierte Toggles)
  4. Texthintergründe (nur für den Picking-Pass)
  5. Selektions-Markierungen
  6. Text
  7. Scroll-Spuren
  8. Scroll-Anfasser
  9. Overlay-Outlines

Die Zuordnung erfolgt deklarativ im Theme-Setup. Die tatsächliche Transformation in mathematische Z-Werte passiert erst ganz am Ende der Rendering-Pipeline in einer isolierten Funktion. Dort wird die Enum-Reihenfolge mit einem ausreichend großen Epsilon-Wert multipliziert, der garantierte Tiefenabstände erzeugt.

Lokale vs. Globale Topologie: Das Problem der durchstechenden Buttons
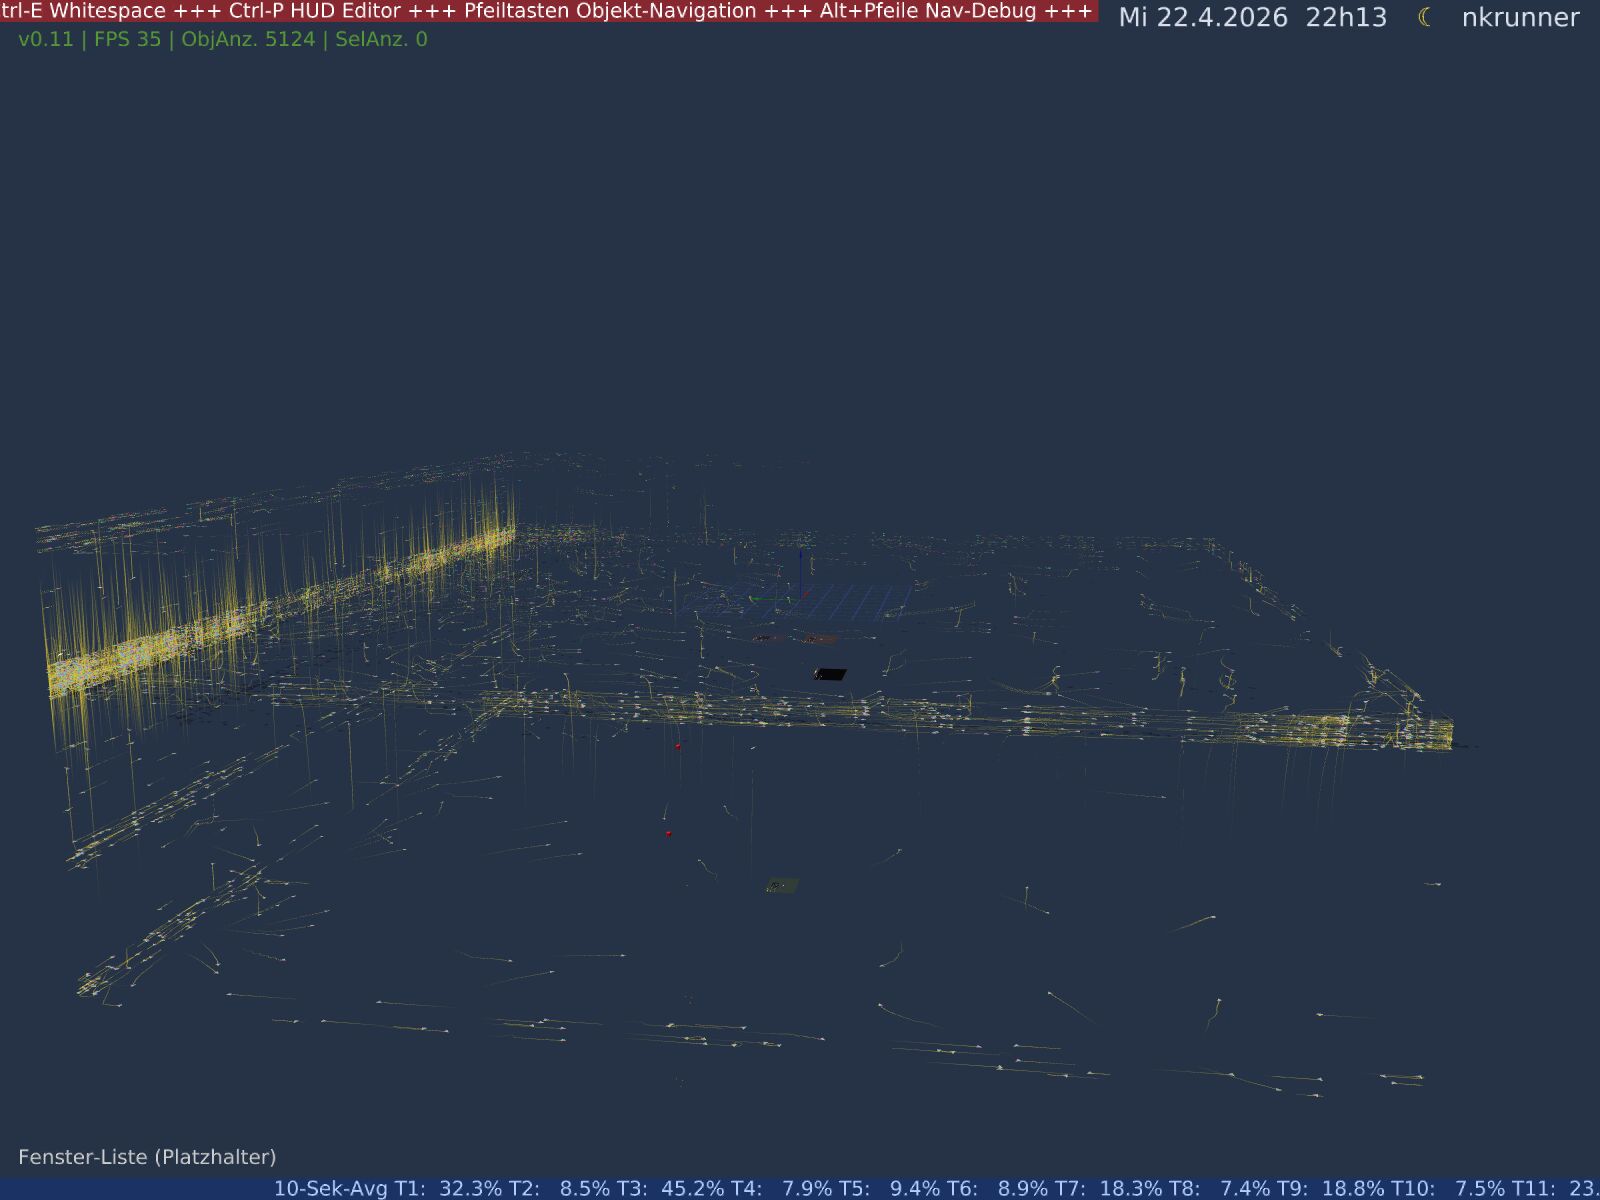
Überlappende Fenster im 3D-Raum

Die Einführung des ADTs für die Z-Ebenen löst das Flackern innerhalb eines Fensters. Damit entsteht jedoch sofort ein Folgeproblem: Die Z-Achse ist nun doppelt belastet. Sie definiert die absolute Position des Fensters im 3D-Raum (Global Z), aber auch die gestapelte Höhe der UI-Elemente auf diesem Fenster (Local Z).

Wenn Fenster A bei Z=0.100 liegt und Fenster B kurz dahinter bei Z=0.090, überdeckt Fenster A das Fenster B korrekt. Wenn nun aber Fenster B einen Button besitzt, der durch unsere ADT-Logik einen lokalen Z-Offset von + 0.015 erhält, liegt dieser Button absolut bei Z=0.105. Die fatale Folge: Der Button des hinteren Fensters durchsticht plötzlich die Hintergrundfläche des vorderen Fensters.

Um dieses "Punch-Through"-Problem zu verhindern, nutzt die Engine einen sogenannten FrameStackCompositor. Er entkoppelt die logische Fensterreihenfolge von der physischen Raumtiefe. Die lokalen Z-Werte aus dem ADT dürfen nicht beliebig auf die Raumkoordinate addiert werden. Sie werden stattdessen in ein streng limitiertes "Z-Band" komprimiert. Der Compositor garantiert mathematisch, dass die gesamte Dicke dieses lokalen Epsilon-Bandes (vom Fenster-Hintergrund bis zur höchsten Scrollbar) stets kleiner ist als der minimal mögliche Abstand zweier Fenster im Haupt-Szenengraph. Jedes Fenster wird beim Rendern somit als in sich geschlossene, atomare Z-Scheibe (Slice) behandelt, deren interne Schichten niemals in den Raum anderer Objekte ausbrechen können.

Fazit

Durch das Heben der Tiefensortierung in einen dedizierten Typen übernimmt der Compiler die Kontrolle über die topologische Korrektheit der Benutzeroberfläche.

Visuelles Z-Fighting bei gekippter Kamera ist physikalisch ausgeschlossen. Noch wichtiger ist jedoch die Stabilisierung des Eingabe-Routings: Verdeckungen im Picking-Buffer durch fehlerhafte Fließkomma-Offsets sind strukturell unmöglich geworden. Die Interaktionsschicht kann sich darauf verlassen, dass das, was logisch vorne liegen soll, vom Rendering-System auch als vorderstes Fragment in den Puffer geschrieben wird.
7. Mai 2026

Devlog: Ctrl-P als ruhiger Einstieg in die Kommandosuche

Heute ging es um eine kleine, aber recht grundlegende Stelle im Editor: Kommandos sollen nicht nur irgendwo existieren, sondern im Arbeitsfluss auffindbar sein. Nicht als großes Einstellungsfenster, nicht als Dokumentationsersatz, sondern als ruhige Übersicht direkt im HUD.

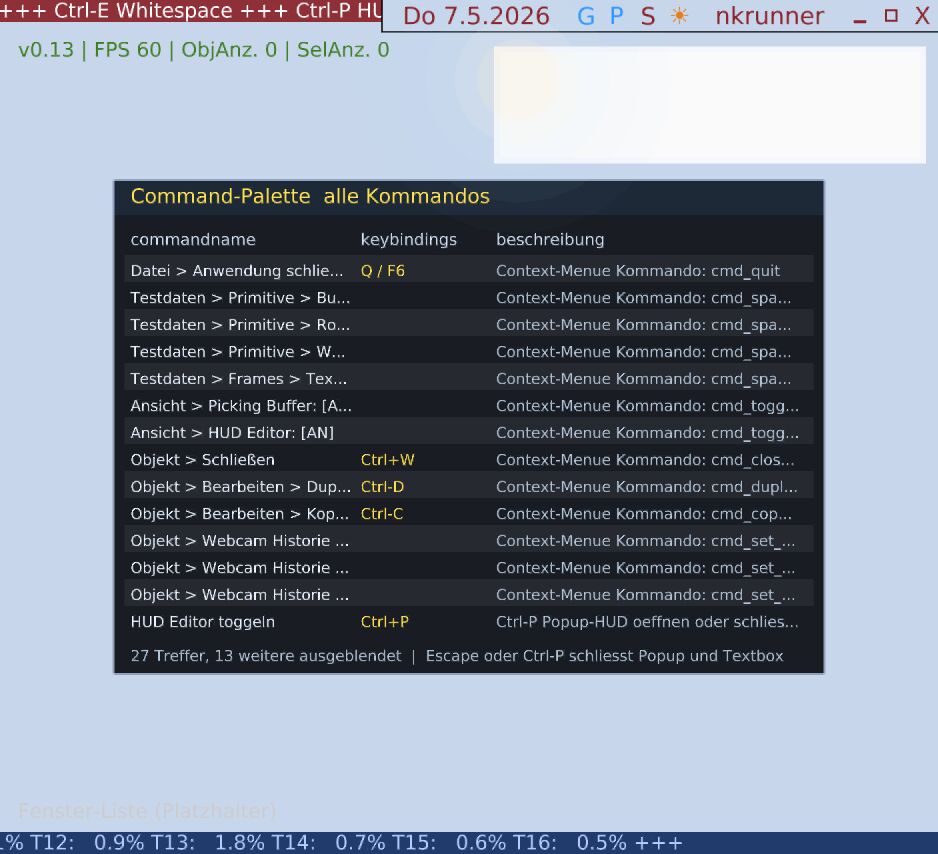
Der Einstieg dafür ist Ctrl-P. Die Taste öffnet den HUD-Editor, und derselbe Text dient jetzt zusätzlich als Suchstring für eine Command-Palette in der Bildschirmmitte.

HUD-Command-Palette

Der konkrete Schritt: Beim Öffnen des HUD-Editors erscheint zusätzlich eine zentrierte Command-Palette. Während man in die Ctrl-P-Textbox tippt, wird die Tabelle gefiltert. Sichtbar sind Kommandoname, Tastenkürzel und eine kurze Beschreibung.

Das klingt zunächst unspektakulär. Genau das ist hier auch beabsichtigt. Es soll kein neues großes Bedienkonzept sein, sondern eine einfache Klärung: Welche Aktionen gibt es gerade, wie heißen sie, wie löse ich sie aus?

Warum das überhaupt nötig ist

Bei einem grafischen Editor wachsen Kommandos oft schleichend. Erst gibt es ein paar Tastenkürzel. Dann ein Kontextmenü. Dann Sonderfälle für Debug-Ansichten, Selektion, Textmodus, Viewports, Hilfsanzeigen. Irgendwann ist das System für den Entwickler noch logisch, für den späteren Benutzer aber nicht mehr unmittelbar sichtbar.

Ctrl-P ist dafür ein guter Ort. Es ist bereits ein temporärer HUD-Einstieg: aufrufen, etwas eingeben, wieder schließen. Die Command-Palette hängt sich an genau diese Bewegung an, statt eine zusätzliche Oberfläche zu erzwingen.

Die Palette ist ein Gegenmittel gegen verstreute Bedienlogik. Sie nimmt vorhandene Kommandos und macht sie als Liste sichtbar. Wichtig ist dabei nicht nur die Anzeige selbst, sondern die Richtung im Code: Kommandos sollen stärker als Daten beschrieben werden. Ein Kommando ist dann nicht nur ein Zweig in irgendeiner Eingabelogik, sondern ein kleiner beschreibbarer Eintrag mit Name, Auslöser und Zweck.

Das ist kein spektakulärer Umbau. Eher ein Aufräumen an einer Stelle, die später sonst teuer wird.

Was sichtbar geändert wurde

Die sichtbare Änderung ist die Tabelle in der Bildschirmmitte. Sie bleibt bewusst schlicht:

  • links der Kommandoname,
  • daneben bekannte Tastenkürzel,
  • rechts eine knappe Beschreibung.

Die Suche ist als Volltextsuche gedacht. Man muss also nicht wissen, ob etwas als Menübefehl, Tastenkürzel oder interne Aktion geführt wird. Ein Begriff reicht, und die Liste schrumpft auf die passenden Einträge.

Das Schließen folgt dem bestehenden Verhalten: Escape beendet den Modus, ebenso erneutes Ctrl-P. Damit bleiben HUD-Textbox und Command-Palette temporäre Werkzeuge und werden kein dauerhaftes Panel, das Platz beansprucht.

Was absichtlich nicht gezeigt wird

Der Screenshot zeigt nur das Ergebnis im UI. Die interessantere Arbeit liegt darunter, aber sie muss nicht öffentlich ausgebreitet werden. Es geht allgemein um weniger Verzweigung, weniger doppelte Beschreibungen und mehr kleine Datentypen, die das Verhalten beschreiben.

Das ist eine nüchterne Architekturarbeit. Keine große neue Engine-Funktion, kein Demo-Effekt. Eher eine Maßnahme gegen künftige Unordnung.

Mir ist dabei wichtig, dass solche Änderungen nicht zu breit werden. Ein kleiner Cluster ist besser als ein halber Umbau. Wenn Eingabe, Menüs, Editorzustand und Rendering gleichzeitig angefasst werden, ist nachher schwer zu sagen, welche Änderung welches Verhalten verursacht hat. Deshalb hier nur ein enger Schnitt: Command-Beschreibung, Filtermodell, HUD-Anzeige.

Warum das zur Richtung des Projekts passt

Das Projekt bewegt sich seit einiger Zeit weg von einzelnen Speziallösungen hin zu beschreibbaren Strukturen. Nicht alles muss sofort eine große DSL werden. Aber Formulare, HUD-Elemente, Kommandos und Zustände sollten so gebaut sein, dass man sie lesen kann, ohne erst zehn Callchains im Kopf zu simulieren.

Eine Command-Palette ist dafür ein guter Prüfstein. Wenn ein Kommando nur durch implizite Logik existiert, lässt es sich schlecht anzeigen. Wenn es als Datenbeschreibung existiert, kann man es filtern, sortieren, dokumentieren oder später anders darstellen.

Ctrl-P wird damit nicht zu einem magischen Sonderfall, sondern zu einem Einstiegspunkt in ein allgemeineres Modell: Text rein, passende Kommandos sichtbar machen, Aktion finden, Modus wieder verlassen.

Das ist der eigentliche Nutzen: Die Anzeige zwingt zu etwas mehr Ordnung.

Stand

Der aktuelle Stand ist bewusst pragmatisch. Die Palette ist da, die Suche funktioniert, und vorhandene Kommandos werden zusammengeführt. Noch ist das kein endgültiges Command-System für alle Eingabearten. Es ist eher ein Zwischenstand, der die Richtung vorgibt.

Der nächste sinnvolle Schritt wäre nicht, sofort mehr Oberfläche zu bauen. Besser wäre, weitere verstreute Kommandobeschreibungen nach und nach in dasselbe Modell zu ziehen. Langsam, testbar, ohne den Rest des Editors dabei unnötig aufzureißen.

Für heute reicht das: Ctrl-P, ein Suchfeld, eine Tabelle, weniger Rätselraten.

4. Mai 2026

Theme-Konfiguration und Architektur-Updates

In den vergangenen Tagen lag der Fokus auf der Flexibilisierung der Benutzeroberfläche und der internen Datenverarbeitung.

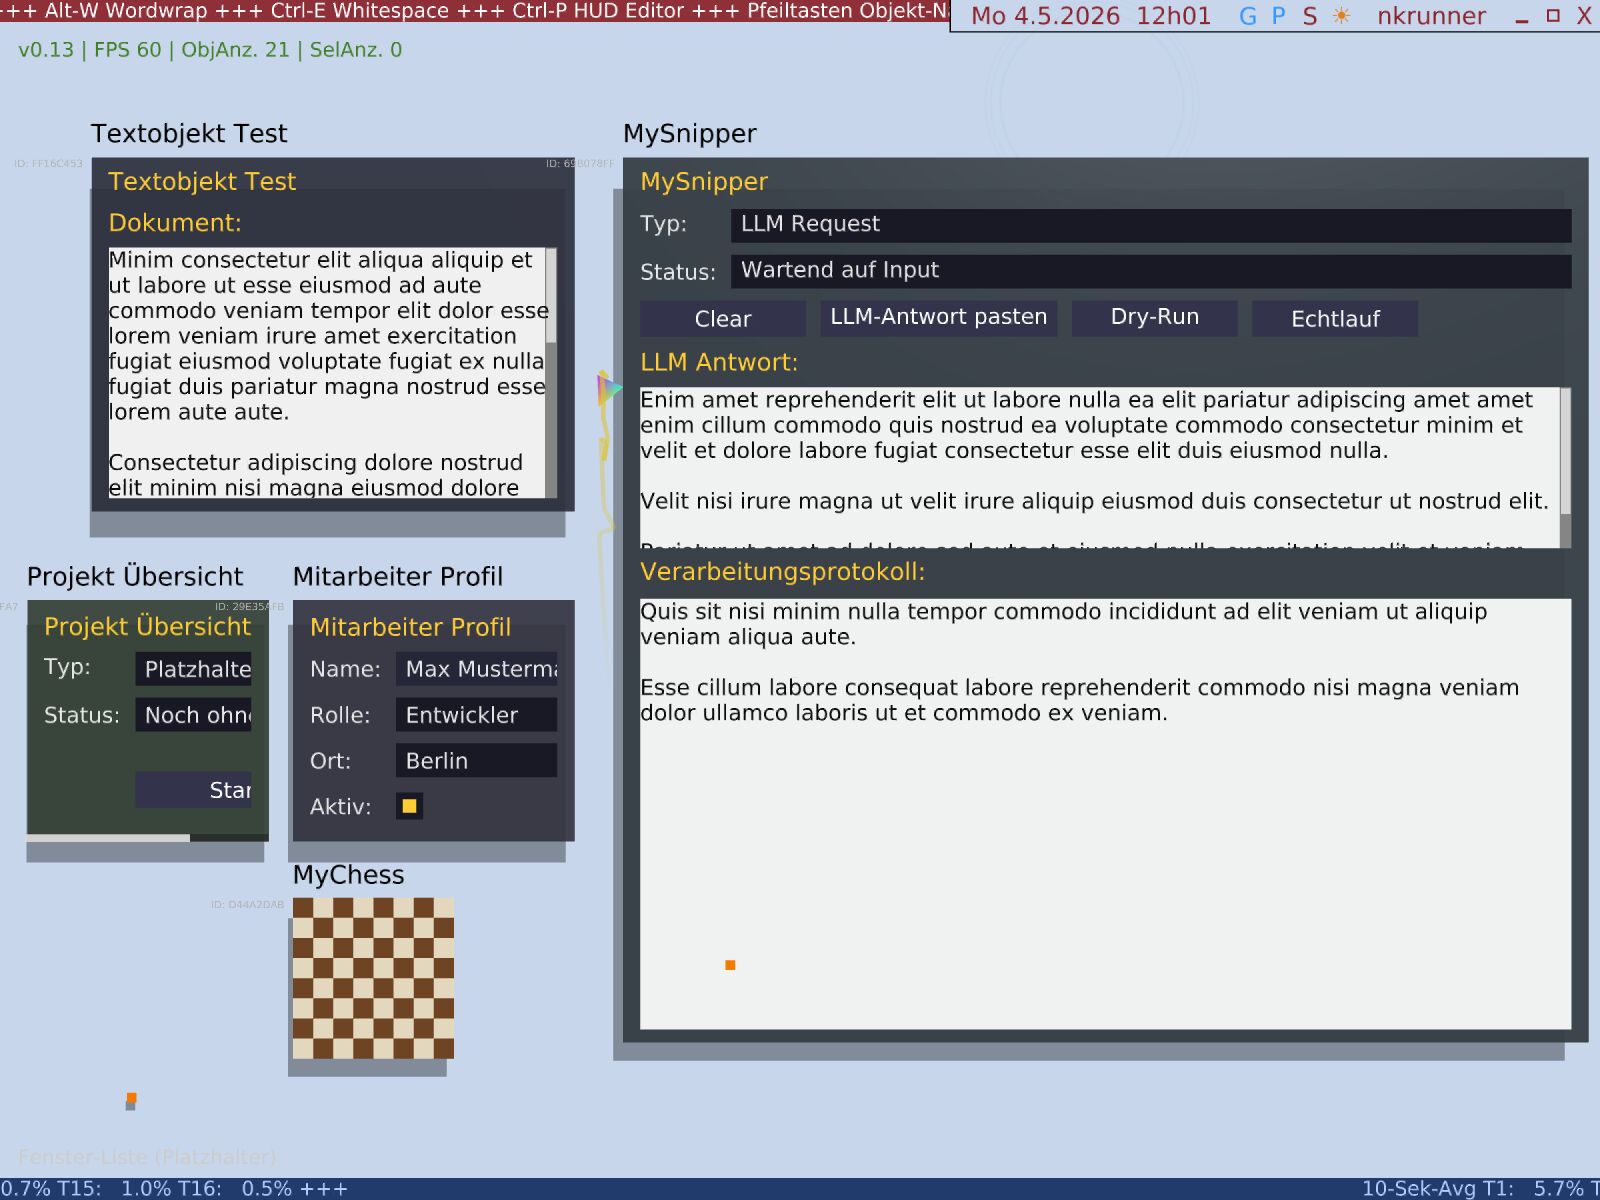
Aktueller Stand der UIAbb 1: Die Spatial UI.

Auslagerung der Theme-Konfiguration

Bisher waren viele farbliche Anpassungen der Benutzeroberfläche fest im Quelltext der Engine verankert. Um das System flexibler zu machen, wurde das Theming (Light/Dark Mode) nun vollständig in die Laufzeitkonfiguration ausgelagert.

Die Farbpaletten werden beim Start aus einer Konfigurationsdatei eingelesen. Zusätzlich wurde eine Automatisierung integriert, die basierend auf der lokalen Systemzeit selbstständig zwischen Tag- und Nachtmodus wechselt. Um den aktuellen Zustand (etwa nach einem manuellen Eingriff des Nutzers) über Neustarts hinweg zu erhalten, schreibt die Engine diese Statusänderungen autonom in eine flüchtige, lokale Einstellungsdatei.

Zusammenfassung aktueller Updates

Neben der UI-Konfiguration wurden in letzter Zeit mehrere strukturelle Erweiterungen an der Engine vorgenommen:

  • Text-Parsing und Ausführungspläne: Es wurde ein lokaler Workflow zur Verarbeitung strukturierter Textdaten (etwa aus LLM-Antworten) implementiert. Ein Parser extrahiert Code-Blöcke aus Rohtexten und erstellt daraus einen isolierten Ausführungsplan. Bevor Dateien lokal geändert werden, bietet das System eine sichere Vorschau (Dry-Run).
  • Lokales Bild-Caching (SQLite): Die Einbindung asynchroner Bildquellen (wie im Webcam-Test) wurde um eine lokale Datenbank-Ebene erweitert. Bilddaten werden im Hintergrund gecacht. Das reduziert redundante Netzwerkanfragen, sichert die Anzeige bei Verbindungsabbrüchen und ermöglicht die Wiedergabe einer lokalen Historie (Time-Lapse).
  • Zustandsverwaltung (Reducers): Die Verarbeitung von Nutzereingaben und UI-Events wurde architektonisch umgebaut. Das System nutzt nun ein strengeres Immutable-State-/Reducer-Pattern, bei dem Eingaben von zustandsfreien Logik-Blöcken verarbeitet werden. Diese generieren saubere, lineare Befehlsketten (Commands), was die Stabilität der UI und die Zuverlässigkeit der Undo/Redo-Historie deutlich erhöht.
  • Räumliche Code-Visualisierung: Ein neues Tooling erlaubt es, Quelltext-Dateien automatisiert auszulesen und als geordnetes Raster von Text-Kacheln im 3D-Raum darzustellen. Dies erleichtert die Navigation und den visuellen Überblick in wachsenden Codebasen.

Die schrittweise Trennung von hartkodierter Logik und konfigurierbaren Datenströmen stabilisiert die Engine als eigenständiges Werkzeug.

27. April 2026

Innerframe-Zooming, Nested Viewports und das Chessboard

Ein globaler Kamera-Zoom stößt bei fensterbasierten 3D-Interfaces schnell an Grenzen. Wenn ein Formular detaillierte Informationen enthält, ist ein gezieltes Vergrößern des Inhalts oft sinnvoller, als die Kameraposition im Raum zu verändern.

Daraus ergab sich die Notwendigkeit für lokales Innerframe-Zooming, verschachtelte Viewports (Nested Scrolling) sowie neue Test-Objekte wie das Chessboard.

Innerframe Zoom und Nested ViewportsAbb 1: Die Benutzeroberfläche mit individuell skalierten Innerframes. Jedes Fenster hält seinen eigenen Zoom-Faktor.

Innerframe-Zooming: Lokaler Maßstab

Jedes virtuelle Fenster besitzt nun einen eigenen zoomScale-Wert im Datenmodell. Mit Ctrl + Mausrad über einem Fenster wird isoliert dessen Inhalt skaliert. Alternativ lässt sich das fokussierte Fenster über die Tastatur mit Ctrl + Numpad+ und Ctrl + Numpad- vergrößern oder verkleinern.

Ein Blick unter die Haube: Die Skalierung erfolgt nicht durch nachträgliches Strecken einer gerenderten Textur. Der Zoom-Faktor wird direkt in den Kontext des Layout-Systems übergeben. Bei der Berechnung des UI-Gitters durch den Worker-Thread werden Parameter wie Margins, Paddings und Font-Metriken mit diesem Faktor multipliziert. Textelemente, die auf Signed Distance Fields (SDF) basieren, werden so mathematisch neu berechnet und bleiben scharf. Fällt der Inhalt aus dem sichtbaren Bereich, werden Scrollbars aktiviert.

Nested Viewports und Nested Scrolling

Um skalierte Inhalte an den Fensterkanten korrekt abzuschneiden, wurde ein System für Nested Viewports (verschachtelte Ansichtsbereiche) implementiert. Wenn ein UI-Element aus einem scrollbaren Formular besteht, das wiederum ein scrollbares Text-Editor-Feld enthält, muss das Clipping über mehrere Ebenen hinweg korrekt berechnet werden.

Verschachteltes vertikales ScrollingAbb 2: Nested Scrolling in Aktion: Ein scrollbarer Editor-Bereich innerhalb eines scrollbaren Hauptformulars.

Durch das angepasste Event-Routing entsteht so ein funktionierendes Nested Scrolling: Die Scroll-Eingabe wird dem Viewport zugeordnet, über dem sich der Mauszeiger befindet. Scrollt der Nutzer über dem Editor-Feld, bewegt sich nur dessen Text. Scrollt der Nutzer im Rest des Formulars, bewegt sich die gesamte Maske.

Ein Blick unter die Haube: Die Umsetzung basiert auf einer Stack-Architektur und geometrischen Schnittmengen. Jedes scrollbare Element legt seine Begrenzungen auf einen Stapel. Liegt ein Child-Element in einem Parent-Element, berechnet das System die Schnittmenge beider Rechtecke (intersect). Nur Render-Befehle, die innerhalb dieser kombinierten Grenzen liegen, werden an den Fragment-Shader der Grafikkarte weitergegeben.

Neue Visualisierung: Das Chessboard

Zur Visualisierung von Datenrastern und Flächen wurde ein Schachbrett-Objekt (wokChessboard) implementiert. Dieses dient gleichzeitig als technischer Testfall für zwei Aspekte:

  1. GPU-Batching: Das Schachbrett berechnet sein Muster zustandsfrei in einem separaten Datensatz für die Worker-Threads. Die Performance bleibt dadurch auch bei mehreren parallel angezeigten Instanzen konstant.
  2. Proportionssperre (Uniform Resize): Ein Raster muss beim Skalieren quadratisch bleiben und darf sich bei Maus-Interaktionen nicht verzerren.

Ein Blick unter die Haube: Für diese Einschränkung wurde die Interaktions-Logik um eine Status-Variable (resizeUniform). Zieht der Nutzer den Maus-Cursor am Fensterrahmen, entstehen Deltas für die X- und Y-Achse. Ist das Flag aktiv, wird der größere der beiden Werte auf Breite und Höhe gleichermaßen angewendet, bevor die Transformations-Matrix aktualisiert wird. Das Grafik-Objekt selbst bleibt dabei von Logik bezüglich des Seitenverhältnisses befreit, da diese in der zentralen Interaktions-Schicht verbleibt.

Dies bildet die technische Grundlage für die Darstellung und Interaktion mit weiteren proportional gebundenen Datenansichten.

25. April 2026

Architektur-Notizen: O(1)-Zugriffe, Worker-Threads und GPU-Batching

In den vergangenen Devlogs ging es oft darum, viele Objekte gleichzeitig darzustellen. Eine ebenso wichtige Anforderung ist jedoch die Interaktion mit diesen Datenmengen.

Wenn man in einer voll ausgelasteten Szene tausende Objekte gleichzeitig selektiert, ändern sich die Anforderungen an die Architektur. Plötzlich müssen für jedes einzelne Objekt zusätzliche Selektionsrahmen berechnet, Schatten-Geometrien aktualisiert und Bewegungsschweife (Trails) gezeichnet werden. Die Menge der zu berechnenden Daten vervielfacht sich schlagartig.

Massenselektion bei tausenden ObjektenAbb 1: Die Engine bei der gleichzeitigen Selektion und Interaktion mit mehreren tausend Objekten.

Vermeidung von O(N²)-Suchen im Szenengraphen

Die Geometrie-Berechnung basiert auf einem hierarchischen Szenengraphen. Wenn nun tausende Objekte pro Frame ihren finalen Zustand für das Rendering berechnen wollen, müssen sie ihre Position im Graph verifizieren und die Transformationen ihrer Elternelemente übernehmen.

Bei naiver Implementierung führt dies zu einer linearen Suche: Für jedes Objekt im Baum muss das zugehörige Datenpaket im flachen Speicher-Array gefunden werden. Bei 3000 Objekten resultiert das in Millionen von linearen Vergleichen auf dem Main-Thread – ein klassischer O(N²)-Flaschenhals.

Exkurs: Was bedeuten O(N²) und O(1)?
In der Softwareentwicklung nutzt man die sogenannte "Big-O-Notation", um zu beschreiben, wie der Rechenaufwand mit wachsender Datenmenge (N) skaliert.

  • O(N²) (quadratisches Wachstum): Wenn man 3000 Objekte hat und jedes Objekt im schlimmsten Fall alle anderen 3000 Objekte durchsuchen muss, entstehen 3000 × 3000 = 9 Millionen Einzelschritte. Verdoppelt sich die Objektanzahl, vervierfacht sich die Rechenzeit. Das zwingt ab einer gewissen Menge jedes System in die Knie.
  • O(1) (konstante Zeit): Der Zugriff dauert immer exakt gleich lang – egal, ob es 10 oder 10 Millionen Objekte gibt. Das System muss nicht suchen, sondern kann die Position im Speicher durch eine mathematische Formel (Hashing) sofort ableiten.

Die Lösung bestand darin, die Traversierungslogik strikt auf konstante Zugriffszeiten (O(1)) umzustellen. Zu Beginn der Render-Vorbereitung wird nun eine Hash-Struktur aufgebaut, die Objekt-IDs direkt auf ihre physischen Speicherindizes abbildet. Die Traversierung des Graphen erfolgt anschließend als reiner, indexbasierter Durchlauf ohne jegliche Suchoperationen. Die CPU-Zeit für diesen Schritt schrumpfte dadurch vom messbaren Millisekundenbereich auf wenige Mikrosekunden.

Nebenläufige Geometrie-Generierung (Lock-free)

Visuelle Indikatoren wie Selektionsrahmen (Outlines), Text-Labels und Hover-Effekte summieren sich bei großen Mengen auf. Jeder Rahmen besteht aus mehreren Dreiecken, die basierend auf Zoomstufe und Kameraperspektive berechnet werden müssen.

Anstatt diese grafischen Elemente sequentiell im Haupt-Thread zu generieren, übernimmt dies nun das datenorientierte Worker-System. Während der Main-Thread noch andere Aufgaben erledigt, bereiten die Hintergrund-Kerne des Prozessors die Geometriedaten parallel vor.

Exkurs: Threads, Mutex und Lock-free Programmierung

  • Threads sind Ausführungsstränge in einem Prozessor. Der Main-Thread ist quasi der Dirigent, während Worker-Threads fleißige Helfer im Hintergrund sind, die gleichzeitig auf anderen Prozessorkernen arbeiten.
  • Mutex (Mutual Exclusion) / Locks: Wenn mehrere Threads gleichzeitig in denselben Arbeitsspeicher schreiben wollen, entsteht Datenmüll. Um das zu verhindern, nutzt man "Locks" (Schlösser) oder "Mutexe" (gegenseitiger Ausschluss): Ein Thread sperrt einen Speicherbereich ab, arbeitet darin, und gibt ihn wieder frei. Der gravierende Nachteil: Alle anderen Threads müssen in dieser Zeit warten (Blockade). Die Parallelität wird künstlich ausgebremst.
  • Lock-free (schlossfrei): Eine Architektur, die Ampeln und Schlösser überflüssig macht. Wie funktioniert das ohne Chaos? Meistens durch strikte Aufteilung oder Hardware-Tricks. Eine Methode ist die Speicher-Partitionierung: Wenn man einen großen leeren Schrank hat, streiten sich die Threads nicht um den nächsten freien Platz, sondern jeder bekommt vorab feste Regalböden zugewiesen. Jeder räumt seine Daten stur in sein eigenes Fach. Da sich die Wege nie kreuzen, muss niemand warten. Eine andere Methode sind atomare Operationen: Hierbei garantiert der Prozessor auf Hardware-Ebene, dass ein Rechenschritt (z.B. das Hochzählen eines Zählers) so winzig und unteilbar ist, dass kein anderer Thread dazwischenfunken kann. Beide Methoden erlauben es, dass alle Threads jederzeit ungestört und konfliktfrei arbeiten.

Der entscheidende Punkt hierbei: Unsere Architektur arbeitet bei der Geometrie-Generierung exakt nach dem ersten Prinzip der Speicher-Partitionierung. Vor dem Start der Worker-Threads berechnet der Main-Thread vorab, wie viele Vertices jedes Objekt generieren wird. Anschließend weist er jedem Task einen präzisen, exklusiven Speicher-Offset (seinen eigenen Regalbereich) in einem riesigen, vorallokierten Array zu. Die Worker können so gleichzeitig ihre Ergebnisse in denselben globalen Puffer schreiben, ohne sich jemals in die Quere zu kommen oder durch Mutexes blockiert zu werden.

Striktes Draw-Call-Batching

Die Vorbereitung auf der CPU ist nur ein Teil der Aufgabe; die Daten müssen auch effizient an die Grafik-API (wie OpenGL oder Vulkan) übergeben werden.

Exkurs: Draw Calls und Batching
Ein Draw Call ist ein Aufruf der CPU an die Grafikkarte (GPU), etwas Bestimmtes zu zeichnen. Die Kommunikation zwischen diesen beiden Prozessoren (über den Grafiktreiber) ist jedoch schwerfällig. Wenn die CPU 3000 Mal ruft: "Zeichne dieses Dreieck!", verbringt das System fast die gesamte Zeit nur mit dem Senden der Befehle. Batching (Bündelung) bedeutet, all diese Objekte in ein einziges, riesiges Paket zu stecken und nur einen einzigen Draw Call zu feuern: "Hier sind 9000 Dreiecke, zeichne sie alle auf einmal!"

Nehmen wir die Bewegungsschweife (Trails) der Agenten: 3000 Agenten bedeuten 3000 Schweife, die aus teils transparenten Polygonen bestehen. Würde man für jeden Schweif einen eigenen Zeichenbefehl an die GPU senden, entstünde ein massiver Overhead. Die CPU verbringt dann mehr Zeit mit dem Kommunizieren des Befehls als die GPU mit dem eigentlichen Rechnen.

Die Lösung hier ist konsequentes Batching: Anstatt für jeden Trail einen zusammenhängenden Pfad (TriangleStrip) zu rendern, wurde die Geometrie so umgebaut, dass alle Trails als einfache, unzusammenhängende Dreiecke definiert werden. Dadurch können die Worker-Threads alle 3000 Schweife in einem einzigen, großen Vertex-Array (Buffer) zusammenfassen. Anstatt tausende Einzelbefehle zu senden, übergibt die Engine der Grafikkarte nun ein einziges, massives Datenpaket mit dem Hinweis, alles mit demselben Shader in einem Rutsch zu verarbeiten.

Fazit

Durch die Kombination aus konstanter Zugriffskomplexität, paralleler, exakt vorausberechneter Speichernutzung und dem radikalen Bündeln von GPU-Befehlen skaliert das System unter Last nun deutlich berechenbarer. Auch bei die Interaktion mit sehr großen Objektmengen bleibt die Benutzeroberfläche verlässlich flüssig.

23. April 2026

Deklarative UI

Das Problem mit imperativem UI-Code

Jeder, der schon einmal komplexe Benutzeroberflächen in einer Custom-Engine von Grund auf neu gebaut hat, kennt die typischen Stolpersteine. Anfangs ist es einfach: Man zeichnet ein Rechteck, schreibt Text hinein und prüft, ob die Maus beim Klicken innerhalb der Koordinaten war.

Doch je mehr die Anwendung wächst, desto schneller vermischt sich die Render-Logik (Wo wird ein Pixel gezeichnet? Welche Farbe hat der Rand?) mit dem Anwendungszustand (Ist der Schalter an oder aus? Welcher Text steht im Feld?). Das führt oft zu hartkodierten Layout-Koordinaten – sogenannten "Magic Numbers" – und extrem starrem Code. Das Hinzufügen eines simplen neuen Eingabefeldes erfordert plötzlich Anpassungen in diversen, tief vergrabenen Dateien der Grafik-Pipeline.

Um das System langfristig wartbar und flexibel zu halten, haben wir uns heute für einen Paradigmenwechsel entschieden: Weg vom imperativen Pixel-Schubsen, hin zu einem strikteren, funktionalen Ansatz, inspiriert von Prinzipien, wie man sie aus modernen deklarativen Frameworks kennt.

Die Lösung: Eine abstrakte Formular-DSL

Anstatt UI-Elemente direkt auf den Bildschirm zu zwingen, definieren wir sie jetzt über eine schlanke, lesbare DSL. Ein Formular existiert im Speicher nur noch als abstraktes Datenmodell – konzipiert als Algebraischer Datentyp (ADT). Es beschreibt lediglich die Struktur (was dargestellt werden soll), enthält aber keinerlei Informationen über das Wie.

Im Code sieht diese abstrakte Definition nun so aus:

// Deklarative und zustandsfreie Definition der UI
const settingsForm = buildForm("settings_id",
  Header("h1", "Mitarbeiter Profil"),
  TextInput("input_1", "Name:", "Max Mustermann", "cmd_edit_name"),
  LabeledValue("val_1", "Rolle:", "Entwickler"),
  Toggle("tgl_1", "Aktiv:", true, "toggle_active"),
  Spacer("sp_1", 0.1),
  Button("btn_1", "Befördern, "cmd_1")
)

Dieser Baum an Informationen ist pure Struktur. Er ist komplett entkoppelt von der Grafik-API.

Mitarbeiter Profil

Immutable State & Redux-Pattern

Der eigentliche Gewinn dieser Architektur zeigt sich in der Interaktion. Wenn der Nutzer beispielsweise auf die Checkbox klickt, ändern wir nicht direkt den Zustand einer UI-Komponente, die gerade auf dem Bildschirm liegt. Wir mutieren keine globalen Variablen.

Stattdessen feuert das System lediglich ein generisches Event – einen "Intent" – mit der entsprechenden Action-ID (z.B. toggle_active). Dieser Intent wandert in einen zentralen Reducer. Dort nutzen wir "reine Funktionen" (Pure Functions), um aus dem alten Zustand eine neue, veränderte Kopie des Formulars zu erzeugen.

// Rein funktionale Zustandsänderung ohne Side-Effects
function toggleFieldValue(form: FormModel, targetId: String): FormModel {
    let newFields = form.fields.map(field => {
        if (field.id == targetId) {
            // Erzeugt eine neue Kopie des Feldes mit invertiertem Status
            return copyWith(field, isActive: !field.isActive)
        }
        return field
    })
    
    // Gibt ein komplett neues Formular-Modell zurück
    return copyWith(form, fields: newFields)
}

Da diese Funktionen keinerlei Nebeneffekte (Side Effects) haben und den bestehenden Speicher nicht überschreiben, lassen sie sich isoliert und blitzschnell mit Unit-Tests validieren. Ein weiterer massiver Vorteil: Da wir für jede noch so kleine Änderung ein komplett neues Modell erzeugen, bekommen wir eine saubere Historie. Ein robustes Undo/Redo-System fällt dabei als architektonisches Nebenprodukt fast kostenlos ab.

Vom Datenmodell auf den Bildschirm

Wie kommt diese abstrakte Datenstruktur am Ende auf den Monitor?

Die Engine nimmt im nächsten Frame das aktualisierte Datenmodell und übersetzt es in einen abstrakten Syntaxbaum für das Layouting. Hier greift ein separat definiertes Theme, das globale Konstanten für Ränder, Abstände und Schriftgrößen enthält. Die Engine berechnet die Layout-Mathematik für Zeilen und Spalten und generiert im allerletzten Schritt eine flache Liste von puren Render-Kommandos (Quads, Text-Vertices, Linien).

Diese vorbereitete, "dumme" Liste wird dann optimiert und in einem Rutsch an die Grafikkarte übergeben.

Fazit

Der Umbau auf einen funktional-deklarativen Architektur-Stil erfordert anfangs etwas mehr Disziplin bei der Modellierung der Datenstrukturen. Die strikte Einbahnstraße des Datenflusses (Datenmodell ➔ Layout-Engine ➔ Render-Befehle) macht sich jedoch bezahlt: Neue UI-Komponenten lassen sich jetzt in Minuten sicher hinzufügen, der Code ist deutlich weniger fehleranfällig und die Rendering-Schicht muss nichts mehr über die Business-Logik der Anwendung wissen.

25. Mai 2026

WebAssembly vs. Flatpak: Deployment-Alternativen für nkrunner

Ein Werkzeug ist nur dann nützlich, wenn man es unkompliziert ausführen kann. Da der nkrunner – unsere Custom UI-Engine – als hardwarenahe Codebasis entwickelt wird, umgehen wir von Haus aus die typischen Abhängigkeits-Orgien moderner Web-Frameworks. Dennoch stellt sich die Frage, wie man die Anwendung am saubersten an den Nutzer ausliefert, ohne in der Linux-Binary-Hölle zu versinken.

Zwei moderne Ansätze drängen sich für ein solches Projekt auf: Flatpak und WebAssembly (Wasm). Beide basieren auf dem Konzept der Sandbox, lösen das Problem aber auf völlig unterschiedlichen Ebenen.

1. Das Sandbox-Modell: Isolation vs. Kapselung

  • Flatpak (Der native Weg): Flatpak nutzt Linux-Kernel-Features (Namespaces, Bubblewrap), um die Anwendung vom restlichen System zu isolieren. Der Code läuft absolut nativ auf der CPU des Hosts. Will die Engine jedoch Konfigurationsdateien lesen oder ins Netzwerk funken, muss sie explizit durch sogenannte XDG-Portals greifen. Das System schützt den Nutzer, erfordert aber Konfigurationsaufwand für das Paket-Manifest.

Exkurs: Die Ursprünge von Flatpak
Flatpak entstand aus dem historischen Bedürfnis, die chronische Fragmentierung des Linux-Desktops zu überwinden. Der Hauptentwickler Alexander Larsson startete das Projekt 2015 unter dem Namen xdg-app. Das primäre Ziel war es, Desktop-Anwendungen unabhängig vom Basis-Betriebssystem und dessen Release-Zyklen auszuliefern. Maßgeblich vorangetrieben und finanziert wird Flatpak bis heute von Red Hat und dem GNOME-Projekt (unter dem Schirm von freedesktop.org). Im Gegensatz zu Canonical, die mit Snap einen stark firmenzentrierten Weg einschlugen, etablierte sich Flatpak als der von der Community bevorzugte, dezentrale Open-Source-Standard für Desktop-Sandboxing.

  • WebAssembly (Die absolute Kapselung): Hier bietet der Browser die ultimative Sandbox. Der Engine-Kern wird in Wasm-Bytecode übersetzt und komplett vom Host-Betriebssystem isoliert ausgeführt. Es gibt keinen direkten, unkontrollierten Zugriff auf das Dateisystem. Höchste Sicherheit für den Nutzer, ohne dass auch nur eine einzige Berechtigung im OS konfiguriert werden muss.

Exkurs: Wer steht hinter WebAssembly?
WebAssembly ist eine technologische Seltenheit: Ein Standard, bei dem sich die sonst konkurrierenden Tech-Giganten einig wurden. Wasm wurde 2015 angekündigt, nachdem sich Vorgängertechnologien wie Mozillas asm.js oder Googles Native Client (NaCl) als zu kompromissbehaftet herausstellten. Entwickelt wurde Wasm in einer beispiellosen Kooperation der großen Browser-Schmieden: Mozilla, Google, Microsoft und Apple. Heute wird der Standard vom W3C (World Wide Web Consortium) gepflegt. Wasm wurde explizit erfunden, um performance-kritische Anwendungen (wie 3D-Engines, Video-Editoren oder CAD-Software) mit nahezu nativer Geschwindigkeit sicher im Browser auszuführen, ohne JavaScript als rechenintensiven Flaschenhals zu nutzen.

2. Grafik und Performance

Die Engine ist darauf getrimmt, tausende Objekte parallel bei stabilen 60 FPS zu rendern. Wie schlagen sich die Zielplattformen dabei?

  • Flatpak: Liefert kompromisslose native Performance. Der nkrunner spricht hier direkt mit den lokalen Grafikkartentreibern des Hosts (OpenGL/Vulkan) und schöpft die Hardware zu 100 % aus.

  • WebAssembly: Da die Architektur unserer Engine strikt plattformunabhängig entworfen ist, lassen sich die internen Grafik-Befehle im Web-Kontext nahtlos nach WebGL2 oder WebGPU übersetzen. Dank moderner JIT-Compiler in den Browsern läuft das überraschend performant und erreicht oft 80–90 % der nativen Geschwindigkeit. Ein minimaler Overhead bleibt durch die Abstraktionsschicht des Browsers bestehen, ist für UI-Anwendungen aber in der Regel vernachlässigbar.

3. Der Cross-Platform-Hebel

  • Flatpak: Bindet das Tooling zwingend an den Linux-Desktop. Das löst das Deployment für unsere Kern-Arbeitsumgebung, lässt aber Windows- oder macOS-Nutzer komplett außen vor.

  • WebAssembly: Das ist der architektonisch eleganteste Pfad. Aus dem gleichen Quelltext purzelt eine einzige .wasm-Datei. Der nkrunner läuft damit sofort und ohne Code-Anpassungen auf Linux, Windows, macOS, Android und iOS. Der Nutzer muss nichts installieren, keine Abhängigkeiten auflösen und keinen Paketmanager bedienen – ein Klick auf eine URL genügt, und die Engine bootet im Tab.

Die Kehrseite: Wo WebAssembly schmerzt

Wenn man den nkrunner als reine Web-App ausliefert, verliert man allerdings fundamentale Eigenschaften eines klassischen Desktop-Werkzeugs. Der Verzicht auf direkten Systemzugriff ist der Preis für die grenzenlose Portabilität:

  • Dateizugriff: Man kann nicht einfach eine lokale Konfigurationsdatei aus ~/.config/nkrunner parsen oder ungefragt Projekte vom Desktop laden. Im Browser ist man auf lokale Datenbanken (IndexedDB) oder die explizite Interaktion über Datei-Dialoge angewiesen.
  • System-Integration: Es gibt keine nativen OS-Menüs, kein echtes Tray-Icon und globale System-Shortcuts des Window-Managers lassen sich nicht einfach kapern.
  • Das "Desktop-Gefühl": Soll sich die Wasm-Version wie eine vollwertige, eigenständige App anfühlen, müsste man sie wiederum in einen nativen Wrapper verpacken (z. B. als sehr leichtgewichtige Web-View-Shell), was den Deployment-Vorteil der reinen URL wieder etwas relativiert.

Fazit für den nkrunner

Für die Entwicklung von interaktiver UI-Logik sind beide Wege extrem wertvoll.

Während der Entwicklung wird die Engine weiterhin rein nativ kompiliert, um blitzschnelle Iterationszyklen und volles Debugging zu garantieren. Für das finale Deployment zeichnet sich jedoch ein hybrider Ansatz ab: Für Power-User, die den nkrunner lokal mit tiefgreifenden Dateisystem-Rechten und maximaler GPU-Leistung nutzen wollen, ist ein Flatpak die sauberste Lösung. Um die Technologie jedoch reibungslos zu demonstrieren oder plattformübergreifend bereitzustellen, ist WebAssembly unschlagbar. Die Engine-Architektur gibt diesen doppelten Weg glücklicherweise her, ohne dass wir uns technisch in eine Sackgasse manövrieren.

21. April 2026

Rendering Optimierungen

Ein System mit einer handelsüblichen APU (Accelerated Processing Unit) verfügt über keine dedizierte Grafikkarte mit eigenem, ultraschnellem VRAM. Stattdessen teilt sich der Chip den normalen Arbeitsspeicher (RAM) zwischen der CPU und der integrierten GPU. Die größte Leistungsbremse in einem solchen System ist nicht mangelnde Rechenkraft, sondern die Speicherbandbreite – also die Frage, wie schnell Daten zwischen RAM, CPU und GPU hin- und hergeschoben werden können.

Um darauf 3000 unabhängige 3D-Agenten und 30 parallele Texteditoren bei flüssigen 60 FPS zu berechnen, reicht "normales" Programmieren nicht aus. Es erfordert Mechanical Sympathy: Die Software-Architektur muss exakt verstehen, wie die Hardware physisch arbeitet (Cache-Hierarchien, Parallelität, Draw-Call-Limits) und ihre Daten entsprechend aufbereiten.

Im Folgenden werden die wichtigsten Mechanismen und ihre genaue Funktionsweise im Detail erklärt.


1. Datenorientiertes Design (Data-Oriented Design)

In der klassischen objektorientierten Programmierung (OOP) ist jedes Objekt ein eigenständiges Konstrukt im Speicher, oft verknüpft durch Zeiger (Pointer).

Das Problem: Wenn die CPU durch 3000 Objekte iteriert, muss sie ständig an völlig unterschiedliche Stellen im RAM springen, um die Daten zu finden. Da der RAM im Vergleich zum kleinen, aber extrem schnellen CPU-Cache sehr langsam ist, muss die CPU warten. Das nennt man einen Cache Miss.

Die Lösung: Die Engine nutzt stattdessen flache, durchgehende Arrays (im Code: Array<WorldObject>).

  • Wie funktioniert das genau? Alle Instanzen der Spielwelt liegen wie Perlen auf einer Schnur direkt hintereinander in einem einzigen, großen Speicherblock. Wenn die CPU das erste Objekt in ihren L1-Cache lädt, lädt sie (aufgrund der Hardware-Architektur) automatisch die nächsten Dutzend Objekte direkt mit. Die CPU kann diese Datenblöcke nun linear und ohne Wartezeiten "durchrattern". Der Overhead durch Speicherzugriffszeiten wird dadurch massiv minimiert.

2. Parallelisierung und Chunking (Arbeitspakete)

Um 3000 Objekte in 16 Millisekunden (für 60 FPS) zu berechnen, muss die Arbeit auf die verfügbaren Kerne und Threads der APU verteilt werden.

Das Problem: Das ständige Erstellen und Zerstören von Threads kostet das Betriebssystem enorm viel Zeit. Wenn mehrere Threads zudem auf dieselben Daten zugreifen wollen, müssen sie sich gegenseitig blockieren (durch sogenannte Mutex-Locks), was zu Staus führt.

Die Lösung: Ein statisches Thread-Pool-Modell mit "Chunking".

  • Wie funktioniert das genau? Beim Start des Programms werden feste "Worker-Threads" gestartet, die dauerhaft im Hintergrund wach bleiben. Die 3000 Objekte werden in feste Blöcke (Chunks) von z. B. 256 Objekten aufgeteilt. Thread 1 bekommt die Objekte 0-255, Thread 2 die Objekte 256-511. Da das Array (siehe Punkt 1) flach ist, weiß jeder Thread genau, wo sein Bereich anfängt und aufhört. Da kein Thread in den Bereich eines anderen schreibt, sind keine Locks notwendig. Die Threads arbeiten völlig unabhängig voneinander und rufen erst wieder ein neues Paket ab, wenn sie fertig sind.

3. Reduktion algorithmischer Komplexität (O(1) Lookups)

Die Engine muss ständig Fragen beantworten wie: An welcher absoluten Koordinate befindet sich Objekt B, wenn es an Objekt A andocken (Snapping) soll?

Das Problem: Wenn 3000 Objekte bei jedem Frame das gesamte Array durchsuchen müssen, um ihre Nachbarn zu finden, skaliert das exponentiell (O(N²)). Bei 3000 Objekten wären das im schlimmsten Fall 9 Millionen Überprüfungen pro Frame – ein sofortiger Einbruch der Framerate.

Die Lösung: Hash-Maps für sofortige Zugriffe.

  • Wie funktioniert das genau? Zu Beginn jedes Frames baut die Engine einmalig eine Tabelle (Hash-Map) auf, die Objekt-IDs (z.B. ID #42) auf den genauen Index im Array (z.B. Platz #15) abbildet. Ein Lookup dauert nun konstante Zeit (O(1)) – es ist, als würde man in einem gut sortierten Telefonbuch direkt den Namen aufschlagen, anstatt jede Seite einzeln zu lesen. Die Traversierung des Szenengraphen ist dadurch extrem leichtgewichtig.

60 FPS sind das ZielAbb 1: Frames und animierte Objekte

4. Zustandsbasiertes UI-Caching

Text-Rendering und UI-Layouting (wie in den 30 virtuellen Code-Editoren) sind extrem teuer. Für jeden Buchstaben muss berechnet werden: Wie breit ist das Zeichen? Passt das nächste Wort noch in die Zeile oder brauche ich einen Zeilenumbruch?

Das Problem: Diese Berechnungen für zehntausende Zeichen jeden Frame neu durchzuführen, würde die CPU überlasten.

Die Lösung: Zwischenspeichern (Caching) der finalen Zeichenbefehle.

  • Wie funktioniert das genau? Aus den Parametern eines Fensters (Breite, Höhe, Textlänge, Scroll-Position) wird ein Fingerabdruck (Hash-Key) erstellt. Bevor die Engine den Text anordnet, prüft sie: Hat sich dieser Fingerabdruck im Vergleich zum letzten Frame geändert?
    • Nein: Die CPU überspringt die gesamte Logik und kopiert einfach die fertigen Geometriedaten (die Dreiecke der Buchstaben) des letzten Frames.
    • Ja (z.B. weil der Nutzer scrollt oder tippt): Nur dieses eine spezifische Fenster wird neu berechnet.

5. CPU-Batching und Render-Graphen

Hier greift die wichtigste Optimierung für die Grafikkarte (GPU).

Das Problem: Eine GPU ist ein Monster darin, Millionen von Dreiecken zu zeichnen. Sie ist aber furchtbar schlecht darin, Befehle entgegenzunehmen. Jeder Befehl der CPU an die GPU ("Zeichne dieses Objekt", genannt Draw Call) hat enormen Overhead im Grafiktreiber. Wenn die CPU 3000 Mal ruft: "Zeichne ein Dreieck!", verbringt das System 90% der Zeit mit dem Kommunikation und nur 10% mit dem eigentlichen Zeichnen.

Die Lösung: Geometrie-Batching und Sortierung.

  • Wie funktioniert das genau? Die Worker-Threads (aus Punkt 2) berechnen die 3D-Koordinaten aller 3000 Objekte fertig auf der CPU und schaufeln die Eckpunkte (Vertices) in ein einziges, riesiges Array im Speicher. Der "Render-Graph" sortiert diese Daten dann nach dem verwendeten Shader oder Material, um GPU-Zustandswechsel zu minimieren. Am Ende schickt die CPU statt 3000 Draw Calls nur eine Handvoll großer Pakete an die GPU: "Hier ist ein Array mit 9000 Dreiecken, male sie alle in einem Rutsch mit demselben Shader." Die GPU kann diese parallel verarbeiten, ohne auf neue Befehle der CPU warten zu müssen.

6. Vektorbasiertes Text-Rendering (SDF - Signed Distance Fields)

Auch das Darstellen von Text muss auf einer APU bandbreitenschonend ablaufen.

Das Problem: Traditionell rendert man Schriften, indem man ein Bild (Textur) mit dem Alphabet in einer bestimmten Auflösung (z.B. Schriftgröße 12) in den Speicher lädt. Will man den Text heranzoomen, wird er unscharf. Braucht man ihn in Größe 48, muss man eine neue, riesige Textur laden. Das verbraucht extrem viel VRAM und Bandbreite.

Die Lösung: SDF (Signed Distance Fields).

  • Wie funktioniert das genau? Die Engine nutzt eine spezielle, sehr kleine Textur. Diese speichert nicht die Farben der Buchstaben, sondern mathematische Distanzwerte. Ein Pixel in dieser Textur sagt nur: "Ich bin 3 Pixel vom Rand des Buchstabens entfernt". Im Shader-Programm auf der GPU passiert dann die Magie: Wenn das GPU-Programm gezeichnet wird, prüft es nur: Ist die Distanz kleiner als 0? Dann bin ich innerhalb des Buchstabens und male den Pixel schwarz. Ist sie größer? Dann bin ich außerhalb und male transparent.

Der Effekt: Mit einer einzigen, extrem speichersparenden Textur lässt sich Text stufenlos, gestochen scharf und in jeder beliebigen Größe (sogar in 3D rotiert) darstellen, ohne dass die APU-Bandbreite belastet wird.


7. Profiling und Telemetrie: Der Nachweis der Optimierung

Um diese ehrgeizigen Ziele zu erreichen und Bottlenecks gezielt zu eliminieren, verfügt die Engine über ein integriertes, hierarchisches Profiling-System sowie Echtzeit-CPU-Telemetrie.

Gleichmäßige CPU-Auslastung (Load Balancing) Die CPU-Last (Load Distribution) wirklich gleichmäßig über alle logischen Kerne zu verteilen, war einer der größten Entwicklungsaufwände innerhalb der Architektur. Ohne sauberes Chunking und intelligentes Multithreading würde der Haupt-Thread bei nahezu 100% blockieren, während die übrigen Kerne im Leerlauf verharren. Die folgende Telemetrie beweist, wie die Arbeitspakete im laufenden Betrieb erfolgreich auf alle logischen Threads (T0 bis T15) des Systems verteilt werden. Einige Ausreißer nach oben (wie T2 und T10) sind erwartet, da hier der Main-Thread das finale Render-Submission an die Grafik-API vornimmt:

=== CPU LOAD DISTRIBUTION (10-Sek-Avg) ===
Zeigt die Auslastung der logischen Prozessorkerne im System.

Core   | Avg Load (%)    | Last Load (%)  
------------------------------------------
T0     | 12.4 %          | 19.4 %         
T1     | 9.3 %           | 9.0 %          
T2     | 28.5 %          | 39.6 %         
T3     | 8.1 %           | 6.8 %          
T4     | 10.0 %          | 10.9 %         
T5     | 11.4 %          | 8.9 %          
T6     | 11.2 %          | 12.6 %         
T7     | 7.5 %           | 6.9 %          
T8     | 19.0 %          | 31.7 %         
T9     | 6.1 %           | 5.9 %          
T10    | 42.5 %          | 22.5 %         
T11    | 9.5 %           | 9.9 %          
T12    | 8.2 %           | 5.9 %          
T13    | 6.9 %           | 8.7 %          
T14    | 9.2 %           | 10.7 %         
T15    | 5.8 %           | 6.9 %          

Hierarchisches Performance-Profil Der eingebaute Profiler misst die exakten Ausführungszeiten auf die Millisekunde genau. Hier zeigt sich die finale Wirksamkeit des datenorientierten Designs und des dynamischen CPU-Batchings. Die Logikberechnung und Geometrie-Aufbereitung von tausenden Objekten (z.B. Logic_Triangles, SceneBatched_Triangles) ist dank Cache-Hit-Optimierungen auf absolute Minimalwerte im niedrigen Millisekunden-Bereich geschrumpft:

=== PERFORMANCE CALL TREE ===
Einheit: Millisekunden (ms)

Call Graph                                         | Calls      | Total (ms)      | Avg (ms)        | Max (ms)       
---------------------------------------------------------------------------------------------------------------------
├─ 1 FrameTotal                                    | 598        | 648.24          | 1.0840          | 2.22           
│  ├─ 1.1 Render_MainScreenPass                    | 598        | 207.07          | 0.3463          | 0.61           
│  │  ├─ 1.1.1 DrawScene_Main                      | 598        | 126.34          | 0.2113          | 0.41           
│  │  │  ├─ 1.1.1.1 DrawScene_NormalPass           | 598        | 89.62           | 0.1499          | 0.34           
│  │  │  │  ├─ 1.1.1.1.1 SceneBatched_VirtualWindows | 598        | 38.90           | 0.0650          | 0.14           
│  │  │  │  │  └─ 1.1.1.1.1.1 VW_DrawObject        | 2392       | 34.93           | 0.0146          | 0.07           
│  │  │  │  │     ├─ 1.1.1.1.1.1.1 VW_DrawMain     | 2392       | 16.63           | 0.0070          | 0.03           
│  │  │  │  │     └─ 1.1.1.1.1.1.2 VW_WindowControls | 2395       | 0.66            | 0.0003          | 0.01           
│  │  │  │  ├─ 1.1.1.1.2 SceneBatched_ExecuteGraph | 598        | 30.83           | 0.0515          | 0.21           
│  │  │  │  │  ├─ 1.1.1.1.2.1 ExecuteGraph_NativeDraws | 598        | 23.66           | 0.0396          | 0.19           
│  │  │  │  │  └─ 1.1.1.1.2.2 ExecuteGraph_Sort    | 598        | 4.94            | 0.0083          | 0.03           
│  │  │  │  ├─ 1.1.1.1.3 SceneBatched_BoundsAndLabels | 598        | 4.83            | 0.0081          | 0.06           
│  │  │  │  ├─ 1.1.1.1.4 SceneBatched_PushGlobalBatch | 598        | 2.63            | 0.0044          | 0.04           
│  │  │  │  ├─ 1.1.1.1.5 SceneBatched_WanderingPoints | 598        | 1.74            | 0.0029          | 0.01           
│  │  │  │  ├─ 1.1.1.1.6 SceneBatched_Triangles    | 598        | 1.42            | 0.0024          | 0.01           
│  │  │  │  └─ 1.1.1.1.7 SceneBatched_RedCubes     | 598        | 0.72            | 0.0012          | 0.01           
│  │  │  ├─ 1.1.1.2 DrawScene_ShadowPass           | 598        | 31.77           | 0.0531          | 0.11           
│  │  │  │  ├─ 1.1.1.2.1 SceneBatched_ExecuteGraph | 598        | 11.87           | 0.0199          | 0.05           
│  │  │  │  │  ├─ 1.1.1.2.1.1 ExecuteGraph_NativeDraws | 598        | 8.62            | 0.0144          | 0.04           
│  │  │  │  │  └─ 1.1.1.2.1.2 ExecuteGraph_Sort    | 598        | 1.10            | 0.0018          | 0.01           
│  │  │  │  ├─ 1.1.1.2.2 SceneBatched_VirtualWindows | 598        | 7.21            | 0.0121          | 0.05           
│  │  │  │  │  └─ 1.1.1.2.2.1 VW_DrawObject        | 2392       | 2.83            | 0.0012          | 0.01           
│  │  │  │  ├─ 1.1.1.2.3 SceneBatched_WanderingPoints | 598        | 2.00            | 0.0033          | 0.01           
│  │  │  │  ├─ 1.1.1.2.4 SceneBatched_RedCubes     | 598        | 0.99            | 0.0017          | 0.01           
│  │  │  │  ├─ 1.1.1.2.5 SceneBatched_Triangles    | 598        | 0.62            | 0.0010          | 0.01           
│  │  │  │  ├─ 1.1.1.2.6 SceneBatched_BoundsAndLabels | 598        | 0.38            | 0.0006          | 0.00           
│  │  │  │  └─ 1.1.1.2.7 SceneBatched_PushGlobalBatch | 598        | 0.18            | 0.0003          | 0.00           
│  │  │  ├─ 1.1.1.3 DrawScene_DebugOverlays        | 598        | 0.22            | 0.0004          | 0.05           
│  │  │  └─ 1.1.1.4 DrawScene_AnchorMarkers        | 598        | 0.08            | 0.0001          | 0.00           
│  │  ├─ 1.1.2 Graphics_Commit                     | 598        | 1.32            | 0.0022          | 0.01           
│  │  └─ 1.1.3 Graphics_EndPass                    | 598        | 0.82            | 0.0014          | 0.01           
│  ├─ 1.2 Render_OffscreenPass_Picking             | 598        | 155.31          | 0.2597          | 0.74           
│  │  ├─ 1.2.1 DrawScene_PickingPass               | 598        | 101.85          | 0.1703          | 0.66           
│  │  │  ├─ 1.2.1.1 SceneBatched_ExecuteGraph      | 598        | 35.89           | 0.0600          | 0.14           
│  │  │  │  ├─ 1.2.1.1.1 ExecuteGraph_NativeDraws  | 598        | 26.95           | 0.0451          | 0.12           
│  │  │  │  └─ 1.2.1.1.2 ExecuteGraph_Sort         | 598        | 6.10            | 0.0102          | 0.06           
│  │  │  ├─ 1.2.1.2 SceneBatched_VirtualWindows    | 598        | 28.54           | 0.0477          | 0.10           
│  │  │  │  └─ 1.2.1.2.1 VW_DrawObject             | 2392       | 23.94           | 0.0100          | 0.05           
│  │  │  │     ├─ 1.2.1.2.1.1 VW_DrawPicking       | 2392       | 6.55            | 0.0027          | 0.02           
│  │  │  │     └─ 1.2.1.2.1.2 VW_WindowControls    | 2392       | 3.83            | 0.0016          | 0.02           
│  │  │  ├─ 1.2.1.3 SceneBatched_WanderingPoints   | 598        | 3.71            | 0.0062          | 0.03           
│  │  │  ├─ 1.2.1.4 SceneBatched_RedCubes          | 598        | 2.43            | 0.0041          | 0.02           
│  │  │  ├─ 1.2.1.5 SceneBatched_BoundsAndLabels   | 598        | 2.40            | 0.0040          | 0.02           
│  │  │  ├─ 1.2.1.6 SceneBatched_Triangles         | 598        | 1.69            | 0.0028          | 0.02           
│  │  │  └─ 1.2.1.7 SceneBatched_PushGlobalBatch   | 598        | 0.45            | 0.0008          | 0.01           
│  │  └─ 1.2.2 Graphics_EndPass                    | 598        | 2.00            | 0.0034          | 0.02           
│  ├─ 1.3 Update_World_Logic                       | 598        | 106.61          | 0.1783          | 0.47           
│  │  ├─ 1.3.1 Logic_Triangles                     | 598        | 72.97           | 0.1220          | 0.18           
│  │  ├─ 1.3.2 Logic_BuildGrid                     | 598        | 5.57            | 0.0093          | 0.04           
│  │  │  ├─ 1.3.2.1 Grid_Gather                    | 598        | 0.76            | 0.0013          | 0.00           
│  │  │  ├─ 1.3.2.2 Grid_FillSlots                 | 598        | 0.24            | 0.0004          | 0.00           
│  │  │  └─ 1.3.2.3 Grid_Sort                      | 598        | 0.19            | 0.0003          | 0.00           
│  │  ├─ 1.3.3 Logic_Wandering                     | 598        | 0.45            | 0.0007          | 0.01           
│  │  └─ 1.3.4 Logic_RedCubes                      | 598        | 0.39            | 0.0006          | 0.01           
│  ├─ 1.4 Build_SceneLayoutCache                   | 598        | 16.15           | 0.0270          | 0.08           
│  │  ├─ 1.4.1 LayoutCache_ExecuteWorkers          | 598        | 8.27            | 0.0138          | 0.06           
│  │  ├─ 1.4.2 LayoutCache_TraverseGraph           | 598        | 4.64            | 0.0078          | 0.04           
│  │  └─ 1.4.3 LayoutCache_Init                    | 598        | 0.28            | 0.0005          | 0.00           
│  ├─ 1.5 Update_UI_Layouts                        | 598        | 3.94            | 0.0066          | 0.02           
│  ├─ 1.6 Update_TextWindow_Metrics                | 598        | 2.03            | 0.0034          | 0.01           
│  │  └─ 1.6.1 TextDoc_EnsureLayout                | 598        | 0.18            | 0.0003          | 0.00           
│  └─ 1.7 Update_OffscreenPass_Preparation         | 598        | 0.16            | 0.0003          | 0.00           
└─ 2 TextDoc_EnsureLayout                          | 223        | 0.02            | 0.0001          | 0.00           

--- Log-Ende ---

Fazit

Die flüssige Performance der Engine auf einer APU resultiert nicht aus roher Gewalt, sondern aus der strikten Vermeidung von Flaschenhälsen.

  1. Die CPU bereitet Daten in flachen Arrays ohne Umwege auf (DOD).
  2. Alle Kerne arbeiten gleichzeitig und balancieren die Last perfekt aus, ohne aufeinander zu warten (Chunking & Load Balancing).
  3. Schwerfällige Berechnungen (wie Text-Layouts) werden nur gemacht, wenn sich wirklich etwas ändert (Caching).
  4. Die GPU wird nicht mit Mikro-Befehlen genervt, sondern bekommt massive Datenpakete am Stück (Batching).
  5. Speicher wird durch smarte Mathematik (SDF-Schriften) geschont.

20. April 2026

Light Theme, schwebende Objekte und räumliche Tiefe

Nachdem in den letzten Tagen vor allem die interne Logik – wie Objekt-Boundaries und das Parallel-Rendering – im Fokus stand, gab es heute ein wichtiges Update für die visuelle Wahrnehmung und Usability unserer Spatial UI.

Die Engine im neuen Light Theme mit schwebenden Objekten und SchattenwurfAbb 1: Die Benutzeroberfläche im Daytime-Modus. Die Fenster sind auf der Z-Achse angehoben und werfen realistische Schatten.

Day/Night-Toggle und das neue Light Theme

Wer produktiv arbeiten will, braucht eine Umgebung, die sich den Lichtverhältnissen anpasst. Oben rechts in der Menüleiste ist deshalb ein neuer Schalter hinzugekommen: Der Daytime/Nighttime-Toggle.

Der Screenshot zeigt direkt das Resultat: Unser neues helles Theme. Die Kontraste wurden so abgestimmt, dass Texte und Rahmen auch vor dem hellen Hintergrundgitter (Grid) gestochen scharf lesbar bleiben.

Echte Räumlichkeit: Objekte auf Z > 0

Das für die Nutzererfahrung wichtigste Update betrifft die Positionierung der Virtual Windows im 3D-Raum. Bisher lagen die Objekte oft flach auf dem Boden auf. Ab sofort heben sich alle UI-Elemente und Frames standardmäßig vom Boden ab (die Z-Koordinate ist nun strikt größer als 0).

In Kombination mit dem neu implementierten Schattenwurf ergibt sich dadurch ein völlig neues Raumgefühl. Das Gehirn kann nun durch die Schattenlänge und -position sofort intuitiv erfassen:

  1. Wie hoch über dem Grid schwebt ein Objekt?
  2. Welches Fenster liegt räumlich vor einem anderen?

Gerade beim Dragging und dem in Version 0.11 optimierten Lasso-Snapping hilft diese optische Rückmeldung enorm, um Objekte treffsicher im Raum zu arrangieren.

Neues HUD-Detail: Der Timestamp

Zusätzlich ist oben rechts in der Ecke ein Live-Timestamp hinzugekommen. Das ist ein kleines, aber sehr praktisches Detail für Werkzeuge, die oft im Vollbild oder in tief verschachtelten Workflows genutzt werden – so behält man stets die aktuelle Zeit im Blick, ohne die Arbeitsumgebung verlassen zu müssen.

19. April 2026

Neue Objekt-Boundaries und verbessertes Snapping

Im Spatial Workspace unserer UI-Engine geht es stetig voran. Nachdem wir in den letzten Tagen die Performance bei tausenden Objekten gesichert haben, lag der Fokus heute auf einem entscheidenden Detail der räumlichen Interaktion: Wie exakt beanspruchen Objekte ihren Platz im Raum und wie verhalten sie sich, wenn sie aufeinandertreffen?

Visualisierung der neuen Objekt-BoundariesAbb 1: Die neuen Boundaries schließen das eigentliche Frame und die dazugehörige Caption in eine gemeinsame Bounding-Box ein.

Das Problem mit den Beschriftungen

Bisher lag der Fokus der Kollisions- und Layout-Logik primär auf dem eigentlichen Fenster (dem Frame). Das führte in der Praxis allerdings zu visuellen und logischen Unsauberkeiten: Sobald ein Objekt eine Beschriftung (die Objcaption) besaß, die über das visuelle Haupt-Frame hinausragte, wurde dieser Platz vom System nicht vollständig respektiert. Beim Andocken von Fenstern konnte es passieren, dass Frames die Texte benachbarter Objekte überlagerten.

Erweiterte Objekt-Boundaries

Um das zu lösen, haben wir die Berechnung der Bounding-Boxen umgeschrieben. Die neuen Objekt-Boundaries umschließen nun konsequent das gesamte Element: Sie fassen das Haupt-Frame und die Objcaption zu einer gemeinsamen, logischen Einheit zusammen. Die Engine "weiß" nun exakt, wie viel Raum ein Objekt mitsamt seiner Metadaten und Titel wirklich benötigt.

Die neue Grundlage für das Snapping-System

Diese architektonische Anpassung ist weit mehr als nur ein optischer Fix. Die neuen Boundaries bilden ab sofort die exakte mathematische Grundlage für die Snappings zwischen den Frames.

Wenn Nutzer nun Virtual Windows im 3D-Raum verschieben und diese aneinander andocken, greift das Constraint-System auf die erweiterten Bounding-Boxen zurück. Das Andocken passiert exakt an den Außenkanten dieser neuen Geometrie – was zu einer völlig neuen, flüssigen Gruppendynamik führt.

Rasten beispielsweise die drei Masken-Frames aneinander ein, bilden sie fortan einen kohärenten Verbund. Zieht man nun an einem dieser Frames, gleiten die anderen beiden durch die magnetische Bindung nahtlos und synchron mit durch den Raum. Das angrenzende Texteditor-Frame hingegen ist von diesem System bewusst ausgenommen; es bleibt stets ein autarkes, frei platzierbares Element, das sich nicht in diesen Bewegungsfluss einklinkt.

Das Ergebnis ist ein extrem sauberes Layout-Verhalten ohne überlappende Texte. Das visuelle Element der Caption ist endgültig zu einem vollwertigen, berechenbaren Teil der räumlichen Geometrie geworden.

17. April 2026

Viewports, Masken und stabile 60 FPS

Heute gibt es ein kurzes technisches Update zum aktuellen Stand unseres maßgeschneiderten UI-Toolkits.

Aktueller Stand der UI mit Viewports und MaskenAbb 1: Die aktuelle Testumgebung im nkrunner mit Fokus auf Fensterverwaltung und Rendering.

Der Entwicklungsschwerpunkt lag in den letzten Tagen auf der Fensterverwaltung und dem Rendering-System. Echte, belastbare Benutzeroberflächen bestehen selten nur aus flachen Elementen – sie benötigen tief verschachtelbare (nestable) Strukturen.

Dafür haben wir in unserem UI-Toolkit nun ein sauberes System für Masken und Viewports implementiert. Scrollbare Bereiche funktionieren jetzt zuverlässig: Sobald ein Child-Element den zugewiesenen Bereich seines Parent-Containers verlässt, wird es visuell und logisch korrekt abgeschnitten (Clipping).

Gleichzeitig lag ein extremer Fokus auf der Performance bei dynamischen Fenstergrößen. Egal wie komplex die Hierarchie der scrollbaren Viewports wird, das Rendering im nkrunner muss absolut flüssig bleiben. Die strikte Vorgabe lautet: Stabile 60 FPS. Das ist keine kosmetische Metrik, sondern elementar wichtig. Sobald ein Werkzeug ruckelt oder bei Größenänderungen des Fensters Framedrops zeigt, geht das Gefühl der direkten Kontrolle verloren.

Der nächste Schritt: Der Datenhub

Das Fundament für das visuelle Layout und das räumliche Eingrenzen (Maskierung) steht und läuft performant. Im nächsten Schritt geht es darum, die Elemente des UI-Toolkits mit echtem Leben zu füllen. Wir werden diese internen Zustände in einem zentralen Datenhub synchronisieren, um grafisches Rendering, Nutzereingaben und die tieferliegende Geschäftslogik sauber (und nebenläufig) miteinander zu verknüpfen.

16. April 2026

Performance-Sprung, Lasso-Selektion und Code-Hygiene

Nach den Architekturanpassungen der letzten Wochen – insbesondere der Umstellung auf Parallelverarbeitung – ging es in den vergangenen Tagen an die spürbare Praxis: Interaktion und Performance unter echter Last.

Aktueller Stand der UI mit tausenden Objekten und Lasso-SelektionAbb 1: Die Spatial UI beim Selektieren und Verschieben von massiven Objektmengen.

Tausende Objekte: Dragging und Lasso-Selektion

Es ist eine Sache, 2000+ Objekte stabil auf den Bildschirm zu zeichnen (wie in Version 0.11 getestet). Eine völlig andere ist es, sie flüssig bedienbar zu machen. Der Fokus lag in diesem Schritt auf der direkten Manipulation im Spatial Workspace.

Das Einfangen von Objekten per Lasso-Selektion und das anschließende Dragging (Verschieben) der gesamten Auswahl durch die Szenerie funktioniert nun absolut reibungslos. Selbst bei tausenden gleichzeitig bewegten Elementen bricht die Framerate nicht ein. Die strikte Trennung von visueller Darstellung und auswertbarer Geometrie (Picking-Logik) greift hier perfekt ineinander.

Skalierbare Texterfassung

Wer schon einmal eine UI-Engine gebaut hat, weiß: Text ist teuer. Deshalb haben wir die Skalierbarkeit bei der Texterfassung und dem Text-Rendering gezielt optimiert. Eingaben, Umbrüche und das Rendering vieler dynamischer Text-Nodes innerhalb der Virtual Windows verbrauchen nun spürbar weniger Ressourcen. Das gibt dem System den nötigen Spielraum, um auch komplexe Layouts performant zu halten.

Aufräumarbeiten und Modularisierung

Schneller Code entsteht selten im Chaos. Um diese Performance-Sprünge zu erreichen – und vor allem für die Zukunft wartbar zu halten –, standen massive Aufräumarbeiten an.

Getreu dem Motto "Orthogonal arbeiten" haben wir die Quellcodes besser aufgeteilt und die Engine stärker modularisiert. Zuständigkeiten sind nun noch schärfer voneinander getrennt. Das macht das System nicht nur effizienter in der Ausführung, sondern auch deutlich angenehmer in der Weiterentwicklung. Das Fundament trägt.

14. April 2026

Wie vermisst man ein System?

Der untere Newsticker meines Runtime-Projekts zeigt keine frei erfundene Engine-Metrik, sondern eine aus Linux abgeleitete Auslastungsstatistik. Die Form ist absichtlich knapp:

10-Sek-Avg T1: 31.4% T2: 18.9% T3: 44.2% ...

Damit diese Zeile überhaupt sinnvoll lesbar ist, muss zuerst klar sein, was hier mit T1, T2, T3 gemeint ist.

Screenshot des unteren NewstickersAbb 1: Der blaue Newsticker unten zeigt die CPU Last

Was ist eine logische CPU?

Unter Linux ist eine logische CPU die Recheneinheit, die der Scheduler einzeln sieht und einzeln belegen kann. Genau diese Einheiten erscheinen in /proc/stat als cpu0, cpu1, cpu2 und so weiter. Die Datei liefert also nicht „Kerne“ im unscharfen Alltagswortlaut, sondern schedulbare Hardware-Einheiten.

Man sollte vier Ebenen auseinanderhalten:

  • Sockel / Prozessor: der physische Chip auf dem Mainboard
  • Core: ein physischer Rechenkern innerhalb dieses Chips
  • Hardware-Thread: eine zusätzliche Ausführungsspur pro Core, typischerweise durch SMT (Simultaneous Multithreading); Intel nennt ein ähnliches Konzept oft Hyper-Threading
  • logische CPU: die vom Betriebssystem sichtbare Scheduler-Einheit; praktisch entspricht sie genau so einem Hardware-Thread

Ohne SMT gilt oft: 1 Core = 1 logische CPU.
Mit SMT gilt oft: 1 Core = 2 logische CPUs.

Daneben gibt es noch Programm-Threads. Das sind Threads meines Prozesses. Sie sind eine Software-Struktur. Logische CPUs sind dagegen eine Hardware-/Scheduler-Struktur. Viele Programm-Threads können im Lauf der Zeit auf dieselben logischen CPUs gelegt werden.

Beispiel: AMD Ryzen 7 5700G

Am AMD Ryzen 7 5700G sieht man diese Trennung gut. Dieser Prozessor hat 8 physische Kerne und 16 Threads. Aus Sicht des Betriebssystems stehen also 16 schedulbare Hardware-Threads zur Verfügung.

Für den Ticker heißt das: Auf einem Ryzen 7 5700G sieht Linux typischerweise cpu0 bis cpu15, also 16 logische CPUs. Wenn im Ticker T1 bis T16 auftauchen, dann sind das nicht 16 physische Kerne, sondern 16 vom Scheduler sichtbare Hardware-Threads. Anders gesagt: Bei diesem Prozessor repräsentiert jeder Eintrag Tn einen der 16 CPU-Threads, nicht einen eigenen Core.

Ausgangspunkt der Messung

Die Datenquelle ist /proc/stat. Dort liefert Linux für jede logische CPU kumulative Zähler, also aufsummierte Zeitanteile seit Systemstart. Die cpuN-Zeilen beschreiben, wie viel Zeit diese konkrete CPU in Zuständen wie user, nice, system, idle und weiteren Kategorien verbracht hat.

Der wichtige Punkt: Das sind keine fertigen Prozentwerte, sondern Bestandsgrößen. Ein einzelner Zustand sagt daher noch nichts über aktuelle Last aus. Erst der Vergleich zweier Zustände über ein endliches Intervall macht aus Bestandsgrößen eine lokale Belastungsgröße.

Vom Kernelzähler zur Auslastung

Für jede logische CPU werden in festem Abstand zwei Größen betrachtet:

  • total: gesamte aufgelaufene CPU-Zeit
  • idle: aufgelaufene Idle-Zeit

Dann werden Differenzen gebildet:

  • delta_total = total_neu - total_alt
  • delta_idle = idle_neu - idle_alt
  • delta_busy = delta_total - delta_idle

Die Intervallauslastung ist dann der normierte Busy-Anteil:

  • last_pct = 100 * delta_busy / delta_total

Das ist der entscheidende Schritt: Linux liefert nur kumulative Kernelzähler; die sichtbare Prozentzahl entsteht erst durch Differenzbildung und Normierung.

Warum ein 10-Sekunden-Mittel?

Ein 1-Sekunden-Wert ist korrekt, aber oft zu nervös. Rendering, Scheduling, IRQs und Hintergrundaktivitäten erzeugen kurze Ausschläge, die für einen permanent laufenden Ticker eher Rauschen als Einsicht produzieren. Deshalb wird nicht der letzte Einzelwert direkt angezeigt, sondern pro logischer CPU ein gleitender Mittelwert über die letzten zehn Intervalle gebildet.

Deklarativ gelesen ist die Kette also:

/proc/stat
→ Zustände pro logischer CPU
→ Differenzen über das Messintervall
→ Busy-Anteil
→ normierte Intervallauslastung
→ gleitender 10-Sekunden-Mittelwert
→ Ticker-Darstellung

Oder noch knapper:

Kernel-Zähler
→ delta_total, delta_idle
→ delta_busy
→ last_pct
→ avg_10s
→ T1, T2, T3, ...

Der Ticker zeigt damit keinen Momentanwert im strengen Sinn, sondern einen geglätteten Schätzer der jüngeren Vergangenheit.

Warum die CPU-Sicht und nicht die Thread-Sicht des Programms?

Die Wahl fiel bewusst auf logische CPUs. Prozess-Threads sind nützlich, wenn man Locking, Parallelisierung oder Scheduling innerhalb der Anwendung selbst debuggen will. Die CPU-Sicht beantwortet eine andere Klasse von Fragen: Wird die Last breit verteilt? Gibt es einzelne dauerhaft heißere Hardware-Threads? Ist das System insgesamt eher unterfordert oder nahe an Sättigung? Für einen kompakten Newsticker ist diese Sicht meist die robustere.

Fazit

Der untere Newsticker zeigt also die Auslastung pro logischer CPU, nicht pro Core und nicht pro Programm-Thread. Auf einem AMD Ryzen 7 5700G bedeutet das typischerweise: 8 physische Kerne, 16 Hardware-Threads, also 16 logische CPUs aus Sicht von Linux. Genau diese Einheiten werden aus /proc/stat gelesen, über Differenzen in Intervalllasten übersetzt, über zehn Sekunden geglättet und dann als T1, T2, T3 und so weiter dargestellt.

13. April 2026

Version 0.11 – Parallelisierung & iGPU-Limitierung

Das heutige Update auf Version 0.11 bringt tiefgreifende Änderungen an der Engine-Architektur. Während die visuelle Seite der Spatial UI weiter wächst, stand diesmal die Performance-Analyse unter erschwerten Bedingungen im Vordergrund.

Hauptansicht der Engine v0.11 mit erweiterten Render-ObjektenAbb 1: Die Engine bei über 2000 aktiven Render-Objekten.

Das Test-System: 100 % On-Chip

Um die Leistungswerte realistisch einzuschätzen, hier die Hardware-Konfiguration. Wichtigster Punkt: Es ist keine dedizierte Grafikkarte verbaut. Das System verfügt über keinen PCIe-Grafikbeschleuniger; die gesamte Bildausgabe und Berechnung erfolgt über die integrierte Einheit des Prozes1rs.

  • CPU: AMD Ryzen 7 5700G (8 Kerne, 16 Threads, Zen 3 Architektur)
  • Integrierte GPU: AMD Radeon™ Graphics (Vega 8)
    • Grafikkerne: 8
    • Taktfrequenz: 2000 MHz
    • Speicher: Shared Memory (nutzt einen Teil des System-RAMs)
  • RAM: 32 GB Corsair Vengeance LPX DDR4-3200
  • Mainboard: ASUS ROG Strix B550-F Gaming

Aktuell liegen wir bei >20 FPS bei >2000 aktiven Render-Objekten. Dass wir diese Stabilität rein über die iGPU erreichen, ohne dass eine physische Grafikkarte im Slot steckt, ist ein ehrliches und brauchbares Ergebnis für den aktuellen Optimierungsstand.

Umstellung auf Parallelverarbeitung

Der wichtigste technische Schritt in Version 0.11 war die Umstellung auf Parallelverarbeitung. Wir nutzen nun das Threading-Modell, um die Vorbereitung der Render-Daten und die Objekt-Logik massiv zu parallelisieren.

Dadurch verhindern wir, dass die CPU zum Engpass wird. Die 2000+ Objekte werden effizient verwaltet, sodass der Flaschenhals nun fast ausschließlich bei der Füllrate und den Draw-Calls der integrierten Radeon-Einheit liegt.

Detailansicht des UI-Editors und der Parallel-Tests*Abb 2: Auch bei hoher Last auf der integrierten Grafik

9. April 2026

3D Spatial UI und Text-Editor

Heute möchte ich euch einen Blick auf den aktuellen Stand des Interfaces werfen lassen. Wir haben nun eine funktionierende, räumliche Benutzeroberfläche (Spatial UI), die komplett in unserem Stack gerendert wird.

Hier ist ein aktueller Screenshot aus der Engine:

Vorschau der 3D Spatial UI mit schwebenden Text-Panels und KoordinatensystemAbb 1: Unsere räumliche Benutzeroberfläche mit aktiven Text-Modulen, Selektions-Pfeilen und globalem Koordinatensystem.

Was gibt es Neues zu sehen?

Wie man auf dem Screenshot gut erkennen kann, verschmelzen 2D-UI-Konzepte immer mehr mit der 3D-Welt. Die wichtigsten Neuerungen auf einen Blick:

  1. Virtual Windows: Wir haben mehrere schwebende Panels im Raum platziert ("Mitarbeiter Profil", "Projekt Übersicht", "Aufgabenliste"). Diese Panels sind keine statischen Texturen, sondern echte 3D-Objekte, die im Raum frei bewegt und skaliert werden können.
  2. Der integrierte Texteditor: Das gelb umrandete Panel rechts ("Textobjekt Test") zeigt unseren neuen Texteditor in Aktion. Wie im Textfeld beschrieben:
    • Mit F2 startet man den Edit-Mode direkt im 3D-Raum.
    • Strg+W schaltet den Wordwrap um.
    • Strg+P öffnet zusätzlich unser HUD-Eingabefeld.
  3. Selektion & Snapping: Die gelben und grünen Pfeile, die vom Zentrum ausgehen, visualisieren unser neues Navigations- und Snapping-System. Objekte "wissen", wo sie sich relativ zueinander befinden. Ein Constraint-System sorgt dafür, dass Fenster logisch aneinander andocken können, ohne sich unschön zu überlappen.
  4. Das globale Koordinatensystem: Die X-, Y- und Z-Achsen helfen bei der Orientierung, während die Kamera (mit Maus und Numpad steuerbar) stufenlos heranzoomen oder um die Panels kreisen kann.

Wie geht es weiter?

Das Fundament steht! Das Rendering über den Render-Pass funktioniert performant. Wie bereits im Editor-Testfenster auf dem Screenshot angeteasert, lauten die nächsten Ziele:

  • Verfeinerung der Mauslogik (besseres Drag & Drop Verhalten).
  • "Echte" Inner-Frame-Inputs für die Virtual Windows (z.B. Buttons klicken oder Text markieren).
  • Erweiterung der Undo/Redo-Historie für komplexe Layout-Änderungen.

Bleibt dran, wir nähern uns mit großen Schritten einem voll funktionsfähigen Spatial-Workspace!

8. April 2026

Architektur einer UI-Engine: Interaktion und Zustand

Bei interaktiver Software liegt die eigentliche Arbeit nicht bei Farben, Abständen oder Widget-Namen. Die harten Probleme beginnen dort, wo ein System gleichzeitig Geometrie zeichnen, Eingaben auswerten, Zustände halten und Änderungen wieder zurücknehmen muss. Genau dort trennt sich eine bloße Oberfläche von einem echten Werkzeug.

In meinem aktuellen Engine-Projekt arbeite ich genau in diesem Bereich. Der Kern liegt nicht in einem Satz fertiger Controls, sondern in den technischen Schichten darunter: Objektmodell, Eingabeverarbeitung, zielgenaues Anvisieren (Picking) und Nebenläufigkeit.

Präzises Picking statt reiner Optik

Sichtbare Geometrie und auswertbare Geometrie sind zwei verschiedene Probleme. Ein Element kann optisch korrekt sein und trotzdem für den Nutzer schlecht treffbar. Deshalb nutzt das Projekt eine strikt vom visuellen Rendering getrennte Logik. Die Bedienung hängt daran, dass Dinge pixelgenau und zuverlässig adressierbar bleiben, unbeeinflusst von komplexen visuellen Effekten, Transparenzen oder Überdeckungen.

Zentrale Shader-Architektur & Pipeline

Die grafische Darstellung wird über eine zentrale Architektur gesteuert. Aus einer zentralen Beschreibung werden die passenden Artefakte generiert. Primitive, Tiefentests und Layouts werden pro Pfad explizit gesetzt. Das ist zwingend, denn transparente Überlagerungen, Texte und 3D-Körper haben völlig unterschiedliche Anforderungen an die Grafikkarte.

Nebenläufigkeit ohne Ruckeln

Die wichtigste Regel für flüssige Werkzeuge: Hintergrundarbeit darf den UI-Takt niemals blockieren. Sobald Berechnungen neben den Eingaben laufen, muss der Haupt-Thread frei bleiben. Die Architektur nutzt getrennte Worker-Prozesse, damit die Oberfläche mit konstanten Framerates reagiert, völlig unabhängig davon, wie viel Last das System im Hintergrund verarbeitet.

Der Wert dieses Projekts liegt nicht in einer Sammlung von Einzel-Features, sondern im architektonischen Fundament. Wer diese Probleme in eine gemeinsame, stabile Struktur zwingt, baut ein belastbares Werkzeug.